Ollama 模型库与模型选择
本章节将横向梳理 Ollama 模型库的阅读方法、主流模型家族的定位、量化精度的权衡,最终给你一套按任务选型的实用方法。
模型选对了,一半的性能问题就不存在了。
模型库怎么读:能力标签体系
Ollama 模型库(ollama.com/search)用标签体系标注每个模型的能力,选模型第一步就是按标签过滤。
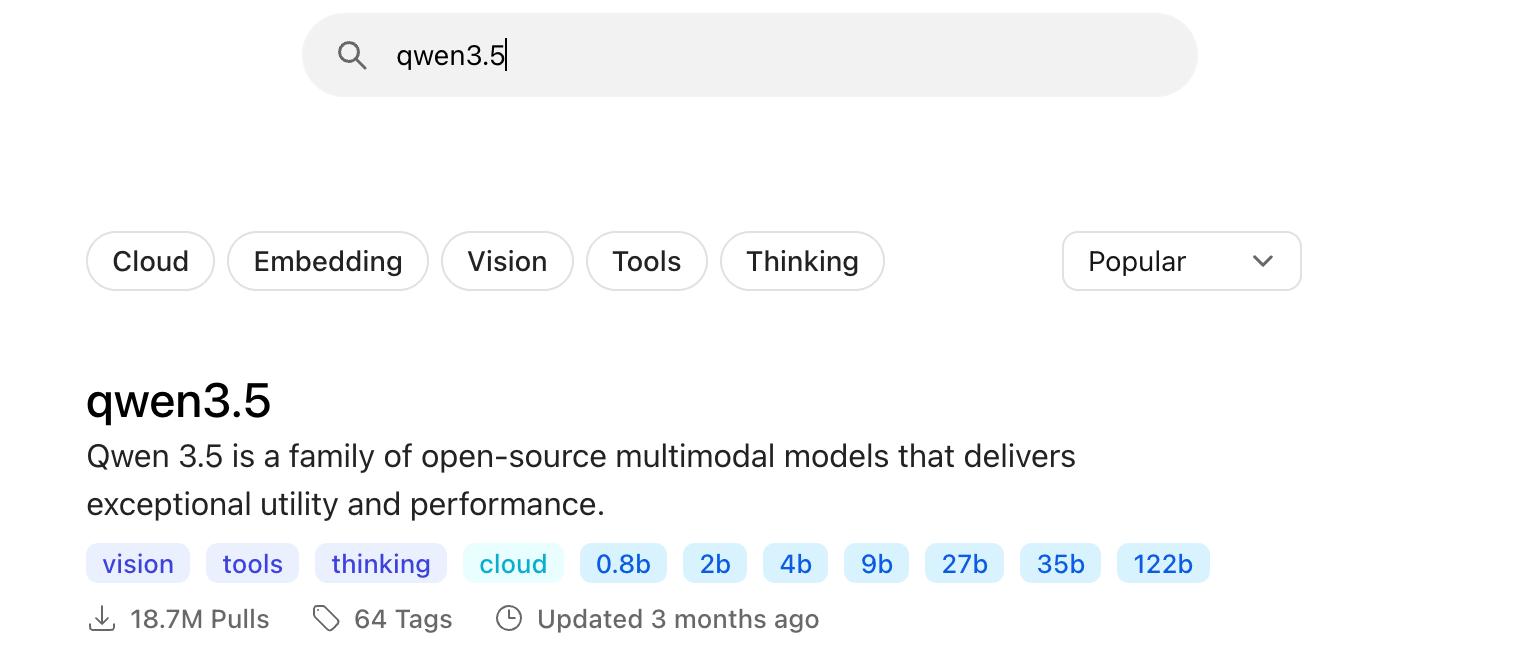
| 标签 | 含义 | 典型用途 |
|---|---|---|
| vision | 支持图像输入 | 看图问答、截图理解、文档识别 |
| tools | 支持工具调用 | Agent、函数调用、自动化 |
| thinking | 支持思考模式 | 数学、逻辑、复杂推理 |
| embedding | 文本转向量 | RAG、语义搜索、知识库 |
| cloud | 云端运行,无需本地算力 | 本地配置不足时调用大模型 |
以本教程的 qwen3.5 为例,它在模型库中同时带有 vision、tools、thinking 标签,属于"全能型"选手,这也是全书选它做测试模型的原因。
每个模型页还会列出全部标签(tag)、下载体积、上下文窗口、输入类型和更新时间,下载前花一分钟读完,能省下大量试错时间。
主流模型家族一览
Ollama 不是模型,而是运行各家开源模型的平台。下面是当前最常见的几个家族:
| 家族 | 出品方 | 定位特点 | 适合场景 |
|---|---|---|---|
| Qwen(通义千问) | 阿里巴巴 | 规格齐全,中文能力强,多模态与工具调用完整 | 中文任务、通用开发、本教程示例 |
| DeepSeek | 深度求索 | 推理系列(R1)以思考链见长 | 数学、逻辑、需要深度推理的任务 |
| Gemma | 轻量规格表现出色,多模态 | 低配设备、轻量任务 | |
| Llama | Meta | 生态最广,社区资料多 | 通用任务、英文场景 |
| GPT-OSS | OpenAI | OpenAI 的开源系列,支持思考档位 | 通用任务、Agent 实验 |
| Mistral | Mistral AI | 欧洲阵营代表,小模型效率高 | 轻量部署、多语言 |
模型迭代速度以周计,具体可用的规格和能力以模型库实时页面为准。选型思路比具体结论更长寿:先定任务和能力标签,再看规格与硬件的匹配。
量化精度:体积与质量的权衡
量化是把模型权重从高精度小数压缩成低位宽存储的技术,是"大模型跑进小显卡"的关键。
同一模型的不同量化版本,体积和质量关系大致如下:
| 精度 | 相对体积 | 质量表现 | 适用场景 |
|---|---|---|---|
| fp16 / fp32 | 基准(最大) | 无损 | 训练、量化前的原始权重 |
| q8_0 | 约 1/2 | 几乎无损 | 显存充裕时的优选 |
| q4_K_M | 约 1/4 | 小幅下降,性价比最高 | 绝大多数本地部署的选择 |
| q4_K_S | 略小于 q4_K_M | 比 q4_K_M 再低一点 | 极限压榨显存 |
模型库里的模型默认已经量化好(常见为 q4_K_M),下载即用,不需要自己操心。
想确认某个本地模型的实际精度,用 show 系列接口或 API 都能查到量化等级;想亲手把一个 fp16 模型压成小体积,用 create 命令的 quantize 参数即可,下一篇 Modelfile 章节有完整演示。
按任务选模型
把"选模型"变成一道分类题:先确定任务,再对照推荐。
| 任务 | 推荐模型 | 硬件参考 | 备注 |
|---|---|---|---|
| 日常对话、写作 | qwen3.5:4b ~ 9b | 16GB 内存可跑 | 性价比首选,能力标签全 |
| 代码生成 | qwen3-coder | 建议 24GB 以上显存 | 配合编码工具需 64K 上下文 |
| 数学、逻辑推理 | deepseek-r1 / qwen3.5 思考模式 | 按规格常规配置 | 开启 think 后更稳但更慢 |
| 看图、截图理解 | qwen3.5(原生视觉) | 与对话规格一致 | 命令行直接传图片路径 |
| RAG、语义搜索 | embeddinggemma / qwen3-embedding | 体积小,要求低 | 嵌入模型不能用来聊天 |
嵌入(embedding)模型和生成模型是两类东西:前者只把文本变成向量,用于检索和相似度计算,不会输出文字回答。搭建知识库时两者都要有,别混用。
体积与硬件匹配
排除法比记忆法好用:先用一条粗略规则判断"跑不跑得动",再微调。
粗略规则:模型下载体积约等于最低内存/显存需求,实际运行再预留 1~2GB 开销,上下文窗口越大追加越多。
| 你的可用内存 / 显存 | 能跑的规格上限 | 建议 |
|---|---|---|
| 8GB | qwen3.5:0.8b ~ 2b | 体验为主,接受能力上限 |
| 16GB | qwen3.5:4b ~ 9b | 日常使用甜点位 |
| 8GB 显存(独立显卡) | qwen3.5:9b | 保持 100% GPU 才有速度 |
| 24GB 显存 | qwen3.5:27b / qwen3-coder | 进阶开发与代码任务 |
| 48GB 显存以上 | 35b+ 与多卡组合 | 默认上下文也会自动加大 |
跑起来之后用 ollama ps 验证:PROCESSOR 列显示 100% GPU 说明全部进了显存;出现 CPU/GPU 混合比例,说明显存不够被切分,速度会明显下降,此时应换更小的规格而不是硬撑。
Cloud 模型与退役机制
本地算力不够,又想用超大模型时,Ollama 提供了第三条路:cloud 标签的云端模型。
实例
# 登录 Ollama 账号(云模型需要)

ollama signin

# 像本地模型一样运行云模型,无需下载权重

ollama run qwen3.5:cloud
云模型的使用方式与本地模型完全一致:同样的命令、同样的 API、同样的工具集成,只是推理发生在 Ollama 的服务器上。
需要注意云模型有退役机制:官方会定期下线旧模型并给出推荐替代,通过邮件和官网公告通知,依赖某个云模型的自动化流程要留意这类通知。
本地模型完全不受退役机制影响,下载到磁盘上的权重永远可以用,这也是纯本地方案最让团队安心的特性。
AI 思考中...