Ollama Cloud 本地与云端混合
本地显存不够,又想用几百 B 参数的超大模型?Ollama Cloud 给了第三种选择:模型在云端 GPU 上跑,你的代码和工具链却感受不到任何变化。
本章节介绍 Cloud 模型的运行方式、直连 API、纯本地模式与退役机制,最后给出混合使用的选型策略。
Cloud 模型是什么
Cloud 模型是 Ollama 的一种新模型形态:权重存放在 Ollama 的云端,推理在官方 GPU 集群完成,本地只负责转发请求。
它解决的痛点非常具体:几百 B 的旗舰开源模型动辄需要数百 GB 显存,个人和小团队根本无法本地部署,但用它的需求又是真实存在的。
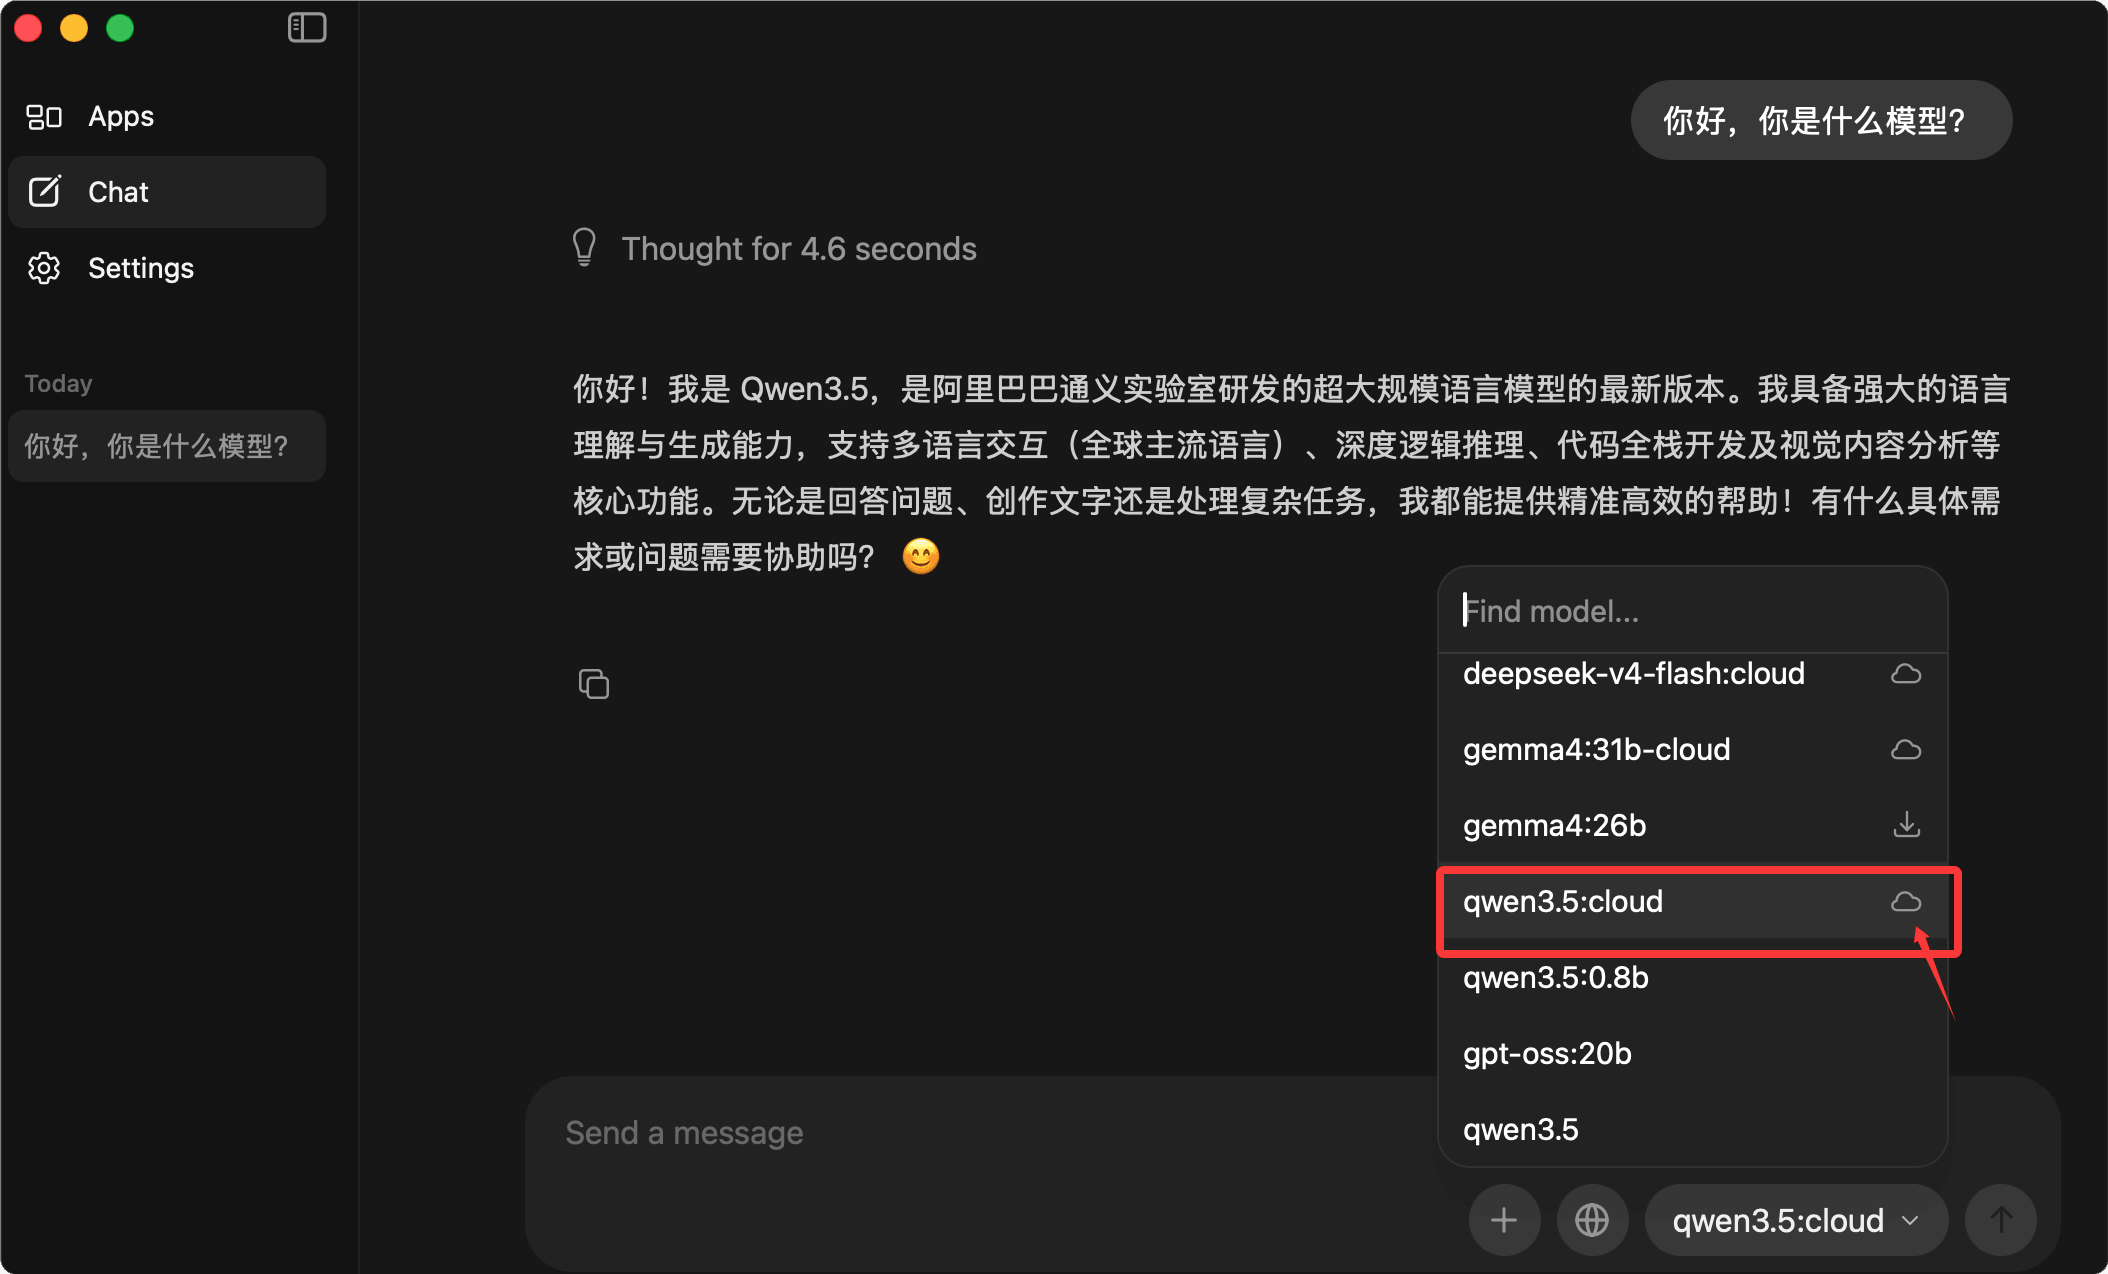
可用的 Cloud 模型在模型库中带 cloud 标签,以 qwen3.5 家族为例,旗舰规格就是 qwen3.5:cloud。
四种方式运行 Cloud 模型
先完成一次性准备:注册并登录 Ollama 账号,然后拉取 cloud 标签(它只是一个"指针",不会下载权重)。
使用登录 Ollama 账号(云模型需要):
ollama signin在浏览器弹出的登录窗口输入邮箱即可(后面如果需要用手机验证,国内手机即可):
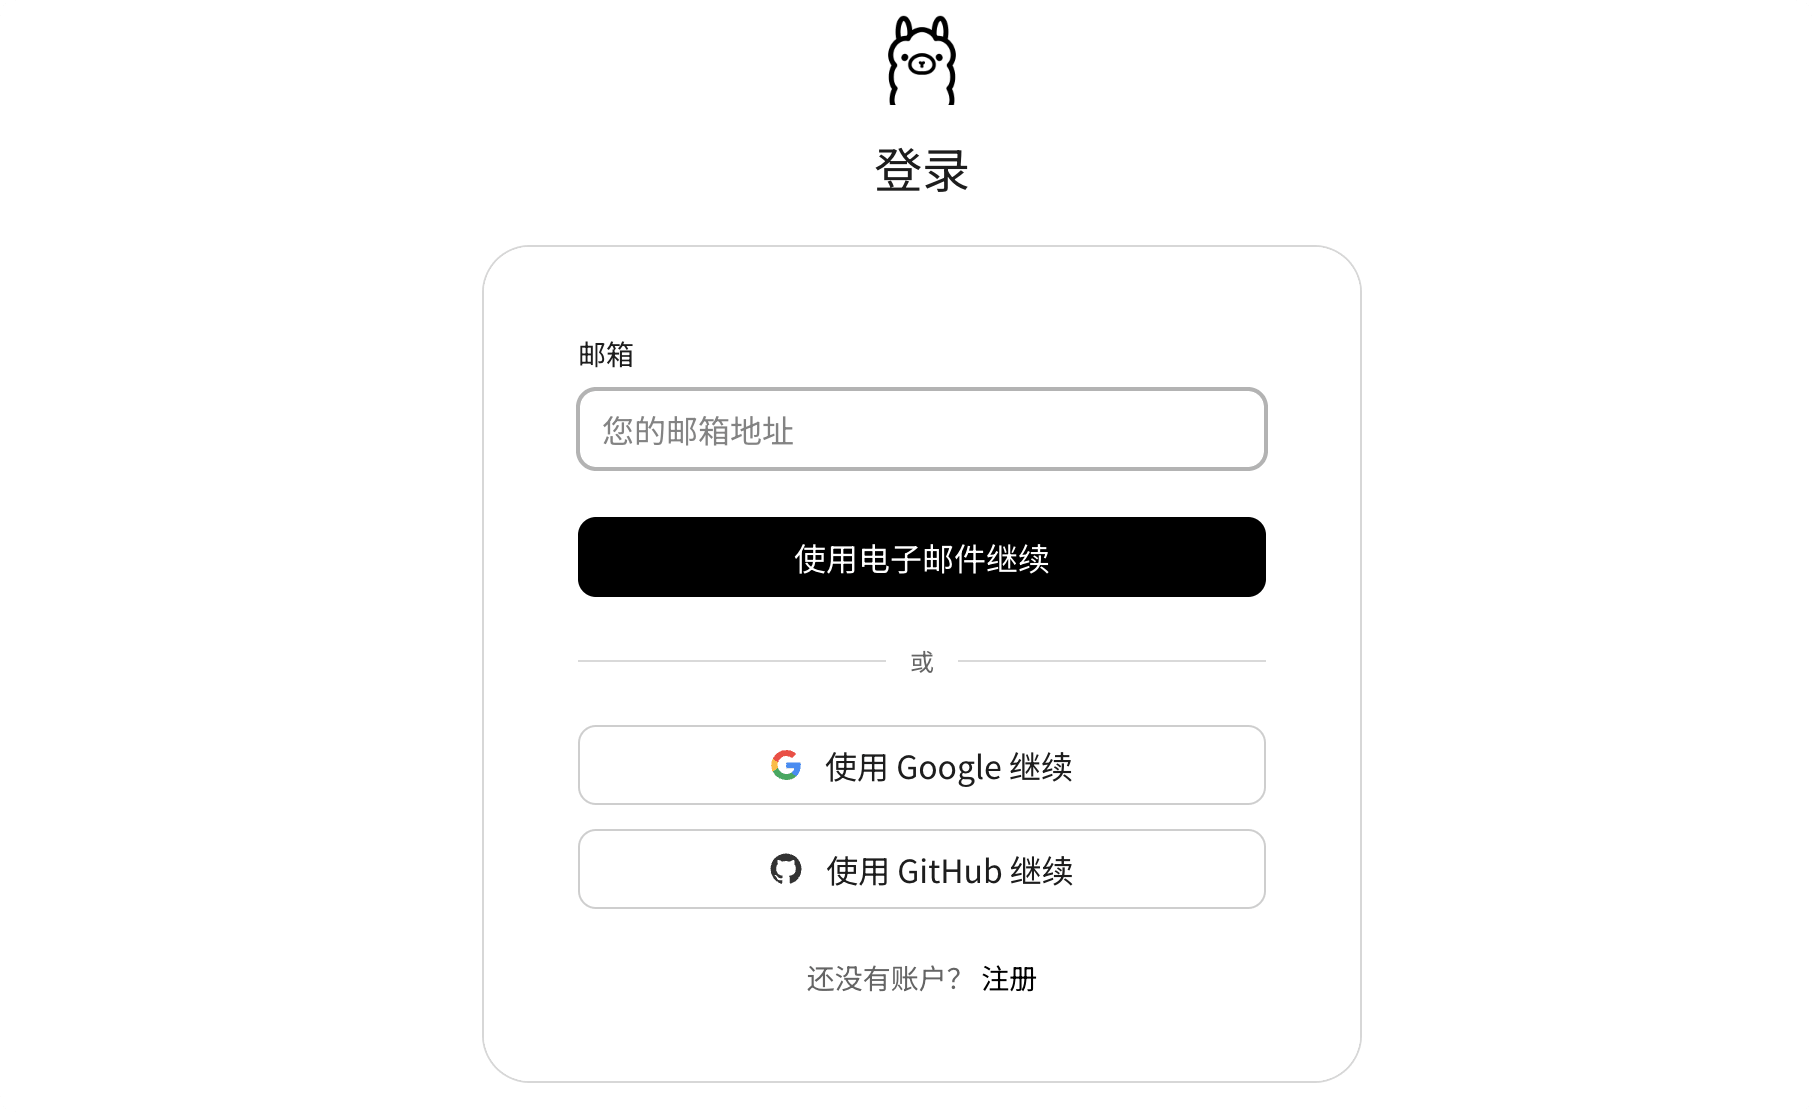
拉取 cloud 标签,几乎瞬间完成:
ollama pull qwen3.5:cloud运行,与本地模型完全一致的体验:
ollama run qwen3.5:cloud界面端可以看到有个云的图标:
Python 调用
实例
from ollama import chat

# 与本地模型唯一的区别:模型名带 :cloud

stream = chat(

    model='qwen3.5:cloud',

    messages=[{'role': 'user', 'content': '用一句话介绍 RUNOOB 菜鸟教程'}],

    stream=True,

)

for chunk in stream:

    print(chunk.message.content, end='', flush=True)
JavaScript 调用
实例
import ollama from 'ollama'

const response = await ollama.chat({

  model: 'qwen3.5:cloud',

  messages: [{ role: 'user', content: '用一句话介绍 RUNOOB 菜鸟教程' }],

  stream: true,

})

for await (const chunk of response) {

  process.stdout.write(chunk.message.content)

}
curl 调用
实例
curl http://localhost:11434/api/chat -d '{

  "model": "qwen3.5:cloud",

  "messages": [{ "role": "user", "content": "用一句话介绍 RUNOOB 菜鸟教程" }],

  "stream": false

}'
透明转发:本地 API 也能调云模型
Cloud 优雅的地方在于转发逻辑完全由本地服务处理。
向 localhost:11434 请求一个 :cloud 模型时,本地服务会自动完成到云端的鉴权与转发,你的应用代码、Agent 工具、编辑器集成完全无感。
这意味着已有集成可以立刻享受大模型能力:把 Claude Code 的模型名换成 qwen3.5:cloud,同一个工具链就切换到了旗舰规格。
当前有一个已知的能力边界:Cloud 模型暂不支持结构化输出(format 参数),需要 JSON Schema 约束的任务仍应安排给本地模型,或在应用层自行解析。
直连 ollama.com/api
除了经本地服务转发,也可以跳过本地直接调用云端 API,适合服务器没有安装 Ollama 的场景。
先在官网设置页创建 API Key,然后以 Bearer 方式携带:
实例
# 云端接口与本地接口路径结构一致

curl https://ollama.com/api/chat \

  -H "Authorization: Bearer $OLLAMA_API_KEY" \

  -d '{

    "model": "qwen3.5",

    "messages": [{ "role": "user", "content": "用一句话介绍 RUNOOB 菜鸟教程" }],

    "stream": false

  }'

# 云端也可列出可用的模型

curl https://ollama.com/api/tags
官方 SDK 同样支持指定 host 与认证头,连接方式见编程接入章节的 Client(host=...) 示例,把 host 换成 https://ollama.com 即可。
API Key 目前不会过期,但可以随时在官网设置页吊销;它等同于你的云端用量凭证,不要提交进代码仓库。
纯本地模式:彻底关掉云端
对数据出域零容忍的团队,可以把 Ollama 的云端功能整体关闭,让它成为纯粹的本地软件。
两种关闭方式任选其一,改完重启 Ollama 生效:
实例
# 方式一:配置文件 ~/.ollama/server.json 写入:

# { "disable_ollama_cloud": true }

# 方式二:环境变量

OLLAMA_NO_CLOUD=1 ollama serve

# 生效后日志中会出现:Ollama cloud disabled: true
关闭云功能会同时失去云模型与联网搜索能力,本地模型的全部功能不受任何影响。配合防火墙封锁出站,可以构建完全物理隔离的模型服务。
云模型的退役机制
云模型有生命周期:随着更强的开源模型发布,官方会定期退役旧云模型,并通过邮件和官网公告提前通知,同时给出推荐替代。
官方公告的样式是一张"退役日期 - 模型 - 推荐替代"映射表,例如某云模型将在某日下线、迁移到哪个新版本,照着换模型名即可。
两条工程建议:
其一,自动化流程里引用云模型时,把模型名做成配置项而不是硬编码,退役切换时只改配置。
其二,关键业务准备好同能力的本地替代模型,云模型退役或网络异常时可立刻降级。
退役只针对云模型:下载到本地的模型权重永远可用,这也是本教程始终强调本地主线的原因。
选型策略:什么时候用哪个
| 场景 | 推荐方案 | 理由 |
|---|---|---|
| 显存装得下的日常任务 | 本地模型 | 零成本、零延迟、数据不出设备 |
| 隐私敏感数据 | 本地模型(或纯本地模式) | 合规可控 |
| 超大模型需求 / 无 GPU 设备 | Cloud 模型 | 无需硬件投入,工具链不变 |
| 新模型尝鲜 | Cloud 先试,确认价值再本地化 | 避免为试用购置硬件 |
| 长期自动化流程 | 本地为主 + 云备用 | 云有退役机制,本地无此风险 |
混合架构的最佳实践一句话:日常流量走本地,重任务按需 :cloud,模型名全部进配置文件。
AI 思考中...