Ollama 简介
Ollama 是一个开源的大型语言模型(LLM)平台,让用户能够轻松地在本地运行、管理和与大型语言模型进行交互。
Ollama 提供了一个简单的方式来加载和使用各种预训练的语言模型,支持文本生成、翻译、代码编写、问答等多种自然语言处理任务。
Ollama 的特点在于它不仅仅提供了现成的模型和工具集,还提供了方便的界面和 API,使得从文本生成、对话系统到语义分析等任务都能快速实现。
与其他 NLP 框架不同,Ollama 旨在简化用户的工作流程,使得机器学习不再是只有深度技术背景的开发者才能触及的领域。
Ollama 支持多种硬件加速选项,包括纯 CPU 推理和各类底层计算架构(如 Apple Silicon),能够更好地利用不同类型的硬件资源。
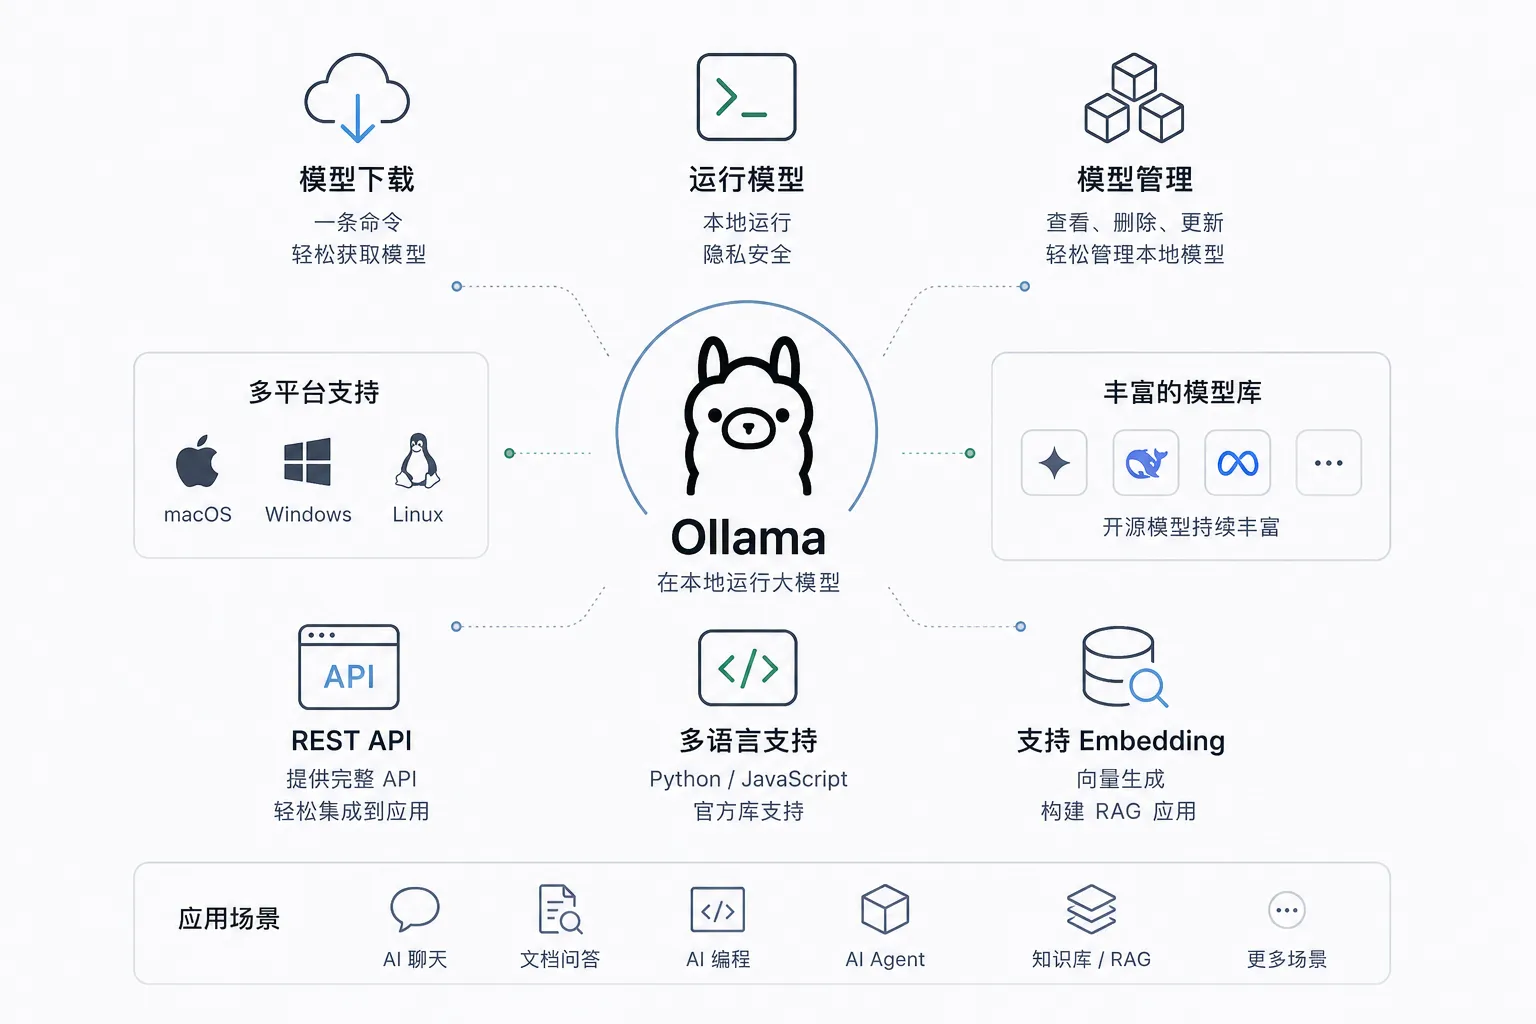
Ollama 是一个由四部分组成的本地模型运行环境。
| 组成部分 | 说明 | 在哪里 |
|---|---|---|
| 命令行工具 | run、pull、list 等所有日常操作的入口 | 系统 PATH 中的 ollama 命令 |
| 后台服务 | 常驻运行,负责模型加载与推理,对外提供 REST API | 本机 11434 端口 |
| 模型库 | 各家开源模型的官方分发渠道,按能力标签分类 | ollama.com/library |
| 本地存储 | 下载的模型权重与配置 | 用户目录下的 .ollama 文件夹 |
新版还提供了两个更友好的入口:直接输入 ollama 打开交互式菜单,以及用 ollama launch 一键把本地模型接入 Claude Code、VS Code 等工具。
核心功能与特点
多种预训练语言模型支持
Ollama 提供了多种开箱即用的预训练模型,包括常见的 GPT、BERT 等大型语言模型。用户可以轻松加载并使用这些模型进行文本生成、情感分析、问答等任务。易于集成和使用
Ollama 提供了命令行工具(CLI)和 Python SDK,简化了与其他项目和服务的集成。开发者无需担心复杂的依赖或配置,可以快速将 Ollama 集成到现有的应用中。本地部署与离线使用
不同于一些基于云的 NLP 服务,Ollama 允许开发者在本地计算环境中运行模型。这意味着可以脱离对外部服务器的依赖,保证数据隐私,并且对于高并发的请求,离线部署能提供更低的延迟和更高的可控性。支持模型微调与自定义
用户不仅可以使用 Ollama 提供的预训练模型,还可以在此基础上进行模型微调。根据自己的特定需求,开发者可以使用自己收集的数据对模型进行再训练,从而优化模型的性能和准确度。性能优化
Ollama 关注性能,提供了高效的推理机制,支持批量处理,能够有效管理内存和计算资源。这让它在处理大规模数据时依然保持高效。跨平台支持
Ollama 支持在多个操作系统上运行,包括 Windows、macOS 和 Linux。这样无论是开发者在本地环境调试,还是企业在生产环境部署,都能得到一致的体验。开放源码与社区支持
Ollama 是一个开源项目,这意味着开发者可以查看源代码,进行修改和优化,也可以参与到项目的贡献中。此外,Ollama 有一个活跃的社区,开发者可以从中获取帮助并与其他人交流经验。
应用场景
内容创作:
帮助作家、记者、营销人员快速生成高质量的内容,例如博客文章、广告文案等。编程辅助::
帮助开发者生成代码、调试程序或优化代码结构。教育和研究:
辅助学生和研究人员进行学习、写作和研究,例如生成论文摘要或解答问题。跨语言交流:
提供高质量的翻译功能,帮助用户打破语言障碍。个人助手:
作为一个智能助手,帮助用户完成日常任务,例如撰写邮件、生成待办事项等。
为什么在本地跑大模型
本地运行不是怀旧,而是四个实打实的理由。
隐私:数据不出设备。合同草案、病历资料、私有代码这些不能离开本机的内容,用云端 API 前总要掂量一遍,本地推理则天然没有这个问题。
成本:没有按 Token 计费。下载模型只花一次磁盘空间和电费,重度使用时边际成本趋近于零,这对需要批量处理文本的场景尤其友好。
离线:不依赖网络。内网环境、机房、飞机上,只要设备在,模型就在;这对现场部署和弱网地区是刚需。
可控:版本和行为可预期。本地模型不会悄悄升级换脑,今天验证过的输出格式,明天不会变;这对生产系统比"更强"更重要。
当然也要诚实地说:本地开源模型的能力上限目前仍低于云端旗舰模型, 选本地方案是"够用、可控、便宜",不是"无所不能"。
与云端 API 的区别与适用场景
把两种方式放在一起对比,选择标准就浮出水面了。
| 维度 | Ollama 本地 | 云端 API(OpenAI、Claude 等) |
|---|---|---|
| 数据位置 | 不出本机 | 上传服务商服务器 |
| 算力来源 | 自己的 CPU / GPU | 服务商数据中心 |
| 费用模型 | 一次下载,免费使用 | 按 Token 持续计费 |
| 模型强度 | 受本机硬件约束 | 可用最强旗舰模型 |
| 离线可用 | 完全可用 | 不可用 |
| 上手成本 | 装一次软件,配一次硬件 | 注册即用,但要管好密钥与账单 |
适用场景也随之清晰:隐私敏感、高频调用、离线环境、学习与开发验证,选本地;需要顶级模型能力、突发弹性流量、自己没有 GPU,选云端 API。
两者不是敌人,成熟产品经常是混合架构:日常请求走本地,少数高难度任务转发云端。
与其他本地方案对比
本地跑大模型不止 Ollama 一条路,常见方案各有人群。
| 方案 | 定位 | 上手难度 | 适合人群 |
|---|---|---|---|
| Ollama | 一条命令跑模型的运行时 + 本地 API 服务 | 低 | 大多数开发者、想快速集成的团队 |
| llama.cpp | 高性能推理引擎本身,参数多、控制粒度细 | 高 | 想深挖推理细节、定制部署的用户 |
| LM Studio | 图形界面桌面应用,内置模型浏览与下载 | 低 | 偏好图形界面、不想碰命令行的用户 |
| vLLM | 面向 GPU 服务器的高吞吐生产级推理服务 | 高 | 高并发线上服务、算力充裕的团队 |
| GPT4All | 轻量桌面应用,主打本地文档对话 | 低 | 非技术背景的普通用户 |
它们的关系值得说一句:Ollama 底层的推理能力正来自 llama.cpp,可以理解为 llama.cpp 之上的"易用封装 + 服务化 + 模型库生态"。
本教程选择 Ollama 作为主线,取的是它的均衡:命令极简、三平台全覆盖、API 与工具生态最完整。对比基于公开资料与 2026 年 8 月的项目状态,各方案都在快速演进。
本地模型 vs Ollama Cloud
前面对比的都是"别家云端",Ollama 自己也提供了云端方案,三种使用大模型的方式就此凑齐。
Ollama Cloud 的使用体验和本地几乎一样:给模型名加上 :cloud 后缀,登录账号后直接运行,本地的命令、API、工具集成原样生效,只是推理被透明地转发到了 Ollama 的服务器。
实例
# 登录 Ollama 账号

ollama signin

# 像本地模型一样运行云模型,无需下载权重

ollama run qwen3.5:cloud
它的价值在两个场景:本机算力跑不动的超大模型,以及买新电脑前"先试试更大的模型值不值"。
云模型有退役机制:官方会定期下线旧云模型并公告替代品,依赖它们的自动化流程需要留意通知;本地模型则永远躺在你的磁盘上,不受任何影响。这一主题在 Cloud 混合部署章节完整展开。
硬件要求与预期
最后一件事:评估自己的机器。Ollama 对硬件的要求出奇地宽容,纯 CPU 也能跑,只是速度有数量级差距。
有独立显卡(NVIDIA、AMD)或 Apple Silicon 芯片时,推理走 GPU 加速,生成速度通常是纯 CPU 的数倍到数十倍。
上下文窗口的默认值由 Ollama 按显存自动分级:
| 显存大小 | 默认上下文长度 |
|---|---|
| 小于 24GiB | 4K |
| 24 ~ 48GiB | 32K |
| 48GiB 及以上 | 256K |
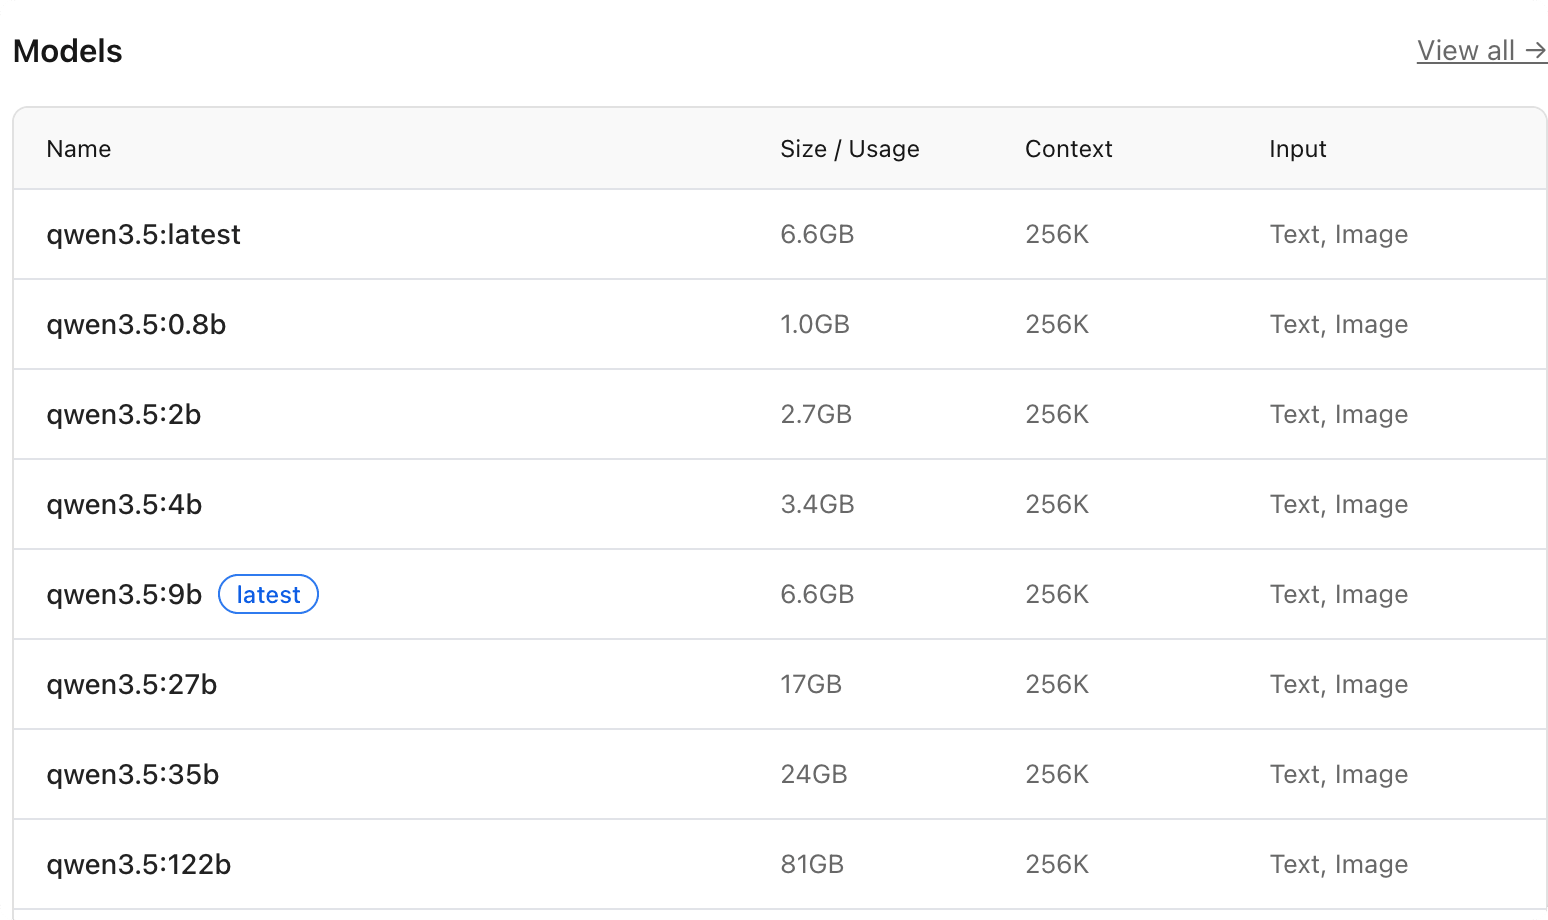
再看参数规模与设备的匹配预期(以 qwen3.5 家族为例 https://ollama.com/library/qwen3.5):
| 模型规格 | 下载体积 | 建议配置 | 体验预期 |
|---|---|---|---|
| qwen3.5:latest | 约 6.6GB | 16GB 内存或 8GB 显存 | 默认规格,质量速度均衡 |
| qwen3.5:0.8b | 约 1.0GB | 8GB 内存即可 | 验证环境、轻量对话 |
| qwen3.5:4b | 约 3.4GB | 16GB 内存 | 日常使用的甜点位 |
| qwen3.5:9b 等同于 qwen3.5:latest | 约 6.6GB | 16GB 内存或 8GB 显存 | 默认规格,质量速度均衡 |
| qwen3.5:27b | 约 17GB | 24GB 显存 | 长文、代码等高要求任务 |
模型跑起来之后,用 ollama ps 命令查看 PROCESSOR 列,就能确认模型是否真的整卡跑在 GPU 上,这个验证动作在模型管理章节会反复用到。
配置实在有限也不用气馁:0.8b 规格足以跑通本教程的绝大多数命令演示;真遇到大模型需求,还有 :cloud 这条不需要硬件的路。
AI 思考中...