LangChain 制作智能体
LangChain 是一个用于构建 LLM 应用的框架,可以把模型调用升级为可组合、可控制、可扩展的应用系统。
LangChain 解决的不是怎么调模型,而是:
- 多步骤推理如何组织
- 外部数据如何接入
- 工具如何被模型安全调用
- 上下文如何被长期管理
开源地址:https://github.com/langchain-ai/langchain。
LangChain 教程:https://www.runoob.com/langchain/langchain-tutorial.html
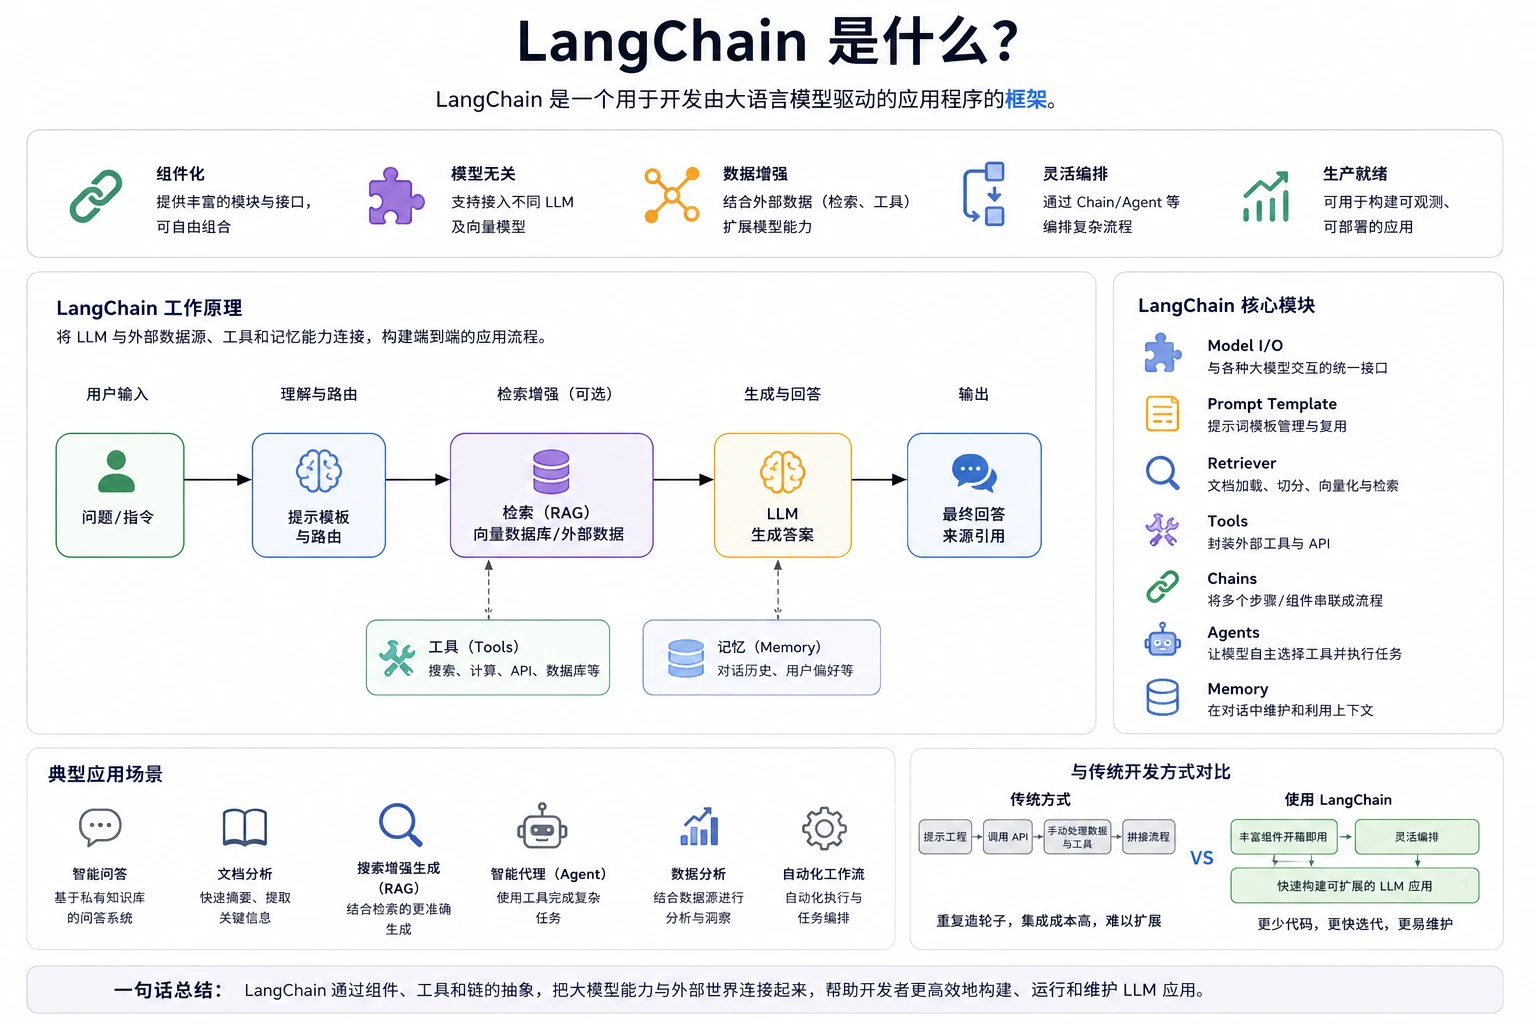
想象一下,你正在建造一个智能机器人助手,这个助手需要能够理解你的问题、从各种资料中查找信息、进行逻辑推理,最后用自然语言回答你。单独使用像 GPT 这样的语言模型,就像只给机器人装了一个聪明的大脑,但它还缺少手和眼睛——它不知道如何获取外部数据、如何执行具体任务。
LangChain 就是这样一个框架,它充当了连接器和协调者的角色。
LangChain 将强大的语言模型(如 GPT-4、DeepSeek)与外部数据源、计算工具以及记忆系统巧妙地连接起来,构建出功能强大、可实际应用的 AI 应用程序。
简单来说,LangChain 的核心价值在于:让语言模型变得有用,解决了大语言模型(LLM)的几个关键限制:
- 知识实时性:LLM 的训练数据有截止日期,无法获取最新信息。
- 领域专精性:通用 LLM 缺乏特定行业或公司的私有知识。
- 可操作性:LLM 本身无法执行如计算、查询数据库、调用 API 等动作。
- 对话连贯性:在多轮对话中,LLM 需要记住之前的聊天历史。
LangChain 通过一系列标准化的链(Chains)和组件(Components)来组织这些功能,让开发者能够像搭积木一样,快速构建复杂的 AI 应用。
你的 AI 应用 LangChain 框架 Models 模型接口 Prompts 提示词 Chains 链/流程 Memory 记忆 Retrieval 检索 Agents & Tools 代理与工具 LLM API 向量数据库 外部工具/API
LangChain 模块总览:
- LLMs / ChatModels:模型接口
- Prompt Templates:Prompt 结构化
- Chains:流程编排
- Memory:上下文管理
- Retrievers / VectorStores:知识检索
- Agents & Tools:自动决策与执行
环境准备
使用国内镜像安装:
pip install langchain langchain-openai langchain-community python-dotenv -i https://mirrors.aliyun.com/pypi/simple/如果你使用 OpenAI 的话,可以配置环境变量:
export OPENAI_API_KEY=你的key然后使用以下代码测试:
实例
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

resp = llm.invoke("用一句话解释什么是 LangChain")

print(resp.content)
国内我们可以采用 DeepSeek 大模型来测试,如果还没有需要先去 https://platform.deepseek.com/api_keys 创建一个 API key。
DeepSeek 的 API 文档参考:https://api-docs.deepseek.com/zh-cn/。
如果你需要统一管理多个第三方模型,可以选择安装 LiteLLM 作为模型网关:
pip install -U litellm不过本文的示例直接使用 ChatOpenAI 配合 openai_api_base 参数连接 DeepSeek,无需额外安装 LiteLLM。
实例
import os

from langchain_openai import ChatOpenAI

# 建议将 API Key 放在环境变量中,或者直接在此处赋值(生产环境请勿硬编码)

# os.environ["DEEPSEEK_API_KEY"] = "sk-你的DeepSeek密钥"

# 初始化模型

llm = ChatOpenAI(

    model="deepseek-v4-pro",             # DeepSeek V4 模型名称

    openai_api_key="sk-你的Key",        # 填入你的 DeepSeek API Key

    openai_api_base="https://api.deepseek.com", # DeepSeek 的 API 地址

    temperature=0.7,

    max_tokens=1024

)

# 测试一下

response = llm.invoke("你好,DeepSeek!请做一个简短的自我介绍。")

print(response.content)
执行以上代码,就会输出内容:
你好!很高兴认识你!

我是DeepSeek,由深度求索公司创造的AI助手。我的特点包括:
。。。
构建 LCEL 链 (LangChain Expression Language)
单纯调用模型不够强大,我们需要构建一个标准的处理流程:
Prompt -> LLM -> OutputParser用户输入 {"concept": "量子纠缠"} | Prompt Template 填充变量 | ChatModel DeepSeek / GPT | OutputParser 解析输出 输出结果 纯文本 LCEL 使用管道符 | 连接各组件,数据从左向右流转
完整代码如下:
实例
from langchain_core.prompts import ChatPromptTemplate

from langchain_core.output_parsers import StrOutputParser

from langchain_openai import ChatOpenAI

# 1. 定义模型 (Model)

llm = ChatOpenAI(

    model="deepseek-v4-pro",

    openai_api_key="你的_DEEPSEEK_API_KEY",

    openai_api_base="https://api.deepseek.com"

)

# 2. 定义提示词模板 (Prompt)

# system: 设定 AI 的角色

# user: 用户的具体输入

prompt = ChatPromptTemplate.from_messages([

    ("system", "你是一个资深的技术专家,擅长用通俗易懂的'大白话'解释复杂的科技概念。你的解释应该包含一个生动的比喻。"),

    ("user", "{concept}")

])

# 3. 定义输出解析器 (Output Parser)

# 将模型的 Message 对象直接转为纯字符串

parser = StrOutputParser()

# 4. 构建链 (Chain) - 使用管道符 | 连接

# 流程:输入字典 -> 填充 Prompt -> 发给 LLM -> 解析输出

chain = prompt | llm | parser

# 5. 调用链

concept_to_explain = "量子纠缠"

print(f"正在解释概念:{concept_to_explain}...\n")

result = chain.invoke({"concept": concept_to_explain})

print("--- DeepSeek 回答 ---")

print(result)
流式输出 (Streaming)
在实际应用(如聊天机器人)中,我们需要像 ChatGPT 那样一个字一个字地吐出文字,而不是等生成完了才一次性显示。
LangChain 对此支持非常简单,使用 .stream() 替代 .invoke():
实例
from langchain_core.prompts import ChatPromptTemplate

from langchain_core.output_parsers import StrOutputParser

from langchain_openai import ChatOpenAI

# 1. 定义模型 (Model)

llm = ChatOpenAI(

    model="deepseek-v4-pro",

    openai_api_key="你的_DEEPSEEK_API_KEY",

    openai_api_base="https://api.deepseek.com"

)

# 2. 定义提示词模板 (Prompt)

# system: 设定 AI 的角色

# user: 用户的具体输入

prompt = ChatPromptTemplate.from_messages([

    ("system", "你是一个资深的技术专家,擅长用通俗易懂的'大白话'解释复杂的科技概念。你的解释应该包含一个生动的比喻。"),

    ("user", "{concept}")

])

# 3. 定义输出解析器 (Output Parser)

# 将模型的 Message 对象直接转为纯字符串

parser = StrOutputParser()

# 4. 构建链 (Chain) - 使用管道符 | 连接

# 流程:输入字典 -> 填充 Prompt -> 发给 LLM -> 解析输出

chain = prompt | llm | parser

# 5. 调用链

concept_to_explain = "量子纠缠"

print(f"正在解释概念:{concept_to_explain} (流式输出)...\n")

# 这里的 chunk 是每次生成的片段

for chunk in chain.stream({"concept": "递归神经网络"}):

    print(chunk, end="", flush=True)
代码结构
Prompt
ChatPromptTemplate明确区分system / user- Prompt 是结构化输入函数,不是字符串
LLM
ChatOpenAI只是统一接口- LangChain 不增强模型能力,只增强可控性
OutputParser
- 模型输出永远是
Message StrOutputParser是显式类型转换- 没有 Parser,工程不可控
核心组件详解
1. 模型 (Models)
LangChain 提供了统一的抽象接口,现在主要推荐使用 Chat Models,因为目前的模型(如 DeepSeek, GPT-4)大多针对对话进行了优化。
- Chat Models: 输入和输出是结构化的消息。
SystemMessage: 设定 AI 角色。HumanMessage: 用户发送的消息。AIMessage: AI 返回的消息。
2. 提示词 (Prompts)
新版本中,推荐使用 ChatPromptTemplate 来构建对话式提示词,它更符合当前主流 LLM 的调用习惯。
from langchain_core.prompts import ChatPromptTemplate

# 使用 from_messages 构建结构化模板
prompt_template = ChatPromptTemplate.from_messages([
    ("system", "你是一位专业的{role}。"),
    ("user", "{content}")
])

# 动态填充变量
prompt = prompt_template.invoke({"role": "美食评论家", "content": "评价一下这碗炸酱面"})
# 输出:包含 SystemMessage 和 HumanMessage 的列表
3. 链 (Chains) & LCEL
重要更新: LLMChain 已被弃用。现在使用 LCEL (管道符 |) 语法。这种方式更灵活、支持异步和流式输出。
# 现代写法:Prompt | Model | OutputParser
from langchain_core.output_parsers import StrOutputParser

# 这里的 llm 是 ChatOpenAI(model="deepseek-v4-pro") 的实例
chain = prompt_template | llm | StrOutputParser()

# 调用链
result = chain.invoke({"role": "导游", "content": "介绍一下故宫"})
print(result) # 直接输出字符串
4. 索引与检索 (Indexes & Retrieval)
这是 RAG (检索增强生成) 的核心。新版本强调了将文档转化为"检索器"的过程。
- 流程:
DocumentLoaders(加载) ->TextSplitter(切片) ->Embeddings(向量化) ->VectorStore(存储)。 - Retriever: 不再仅仅是数据库搜索,它是一个可以集成在链中的组件。
# 将向量库转为检索器
retriever = vectorstore.as_retriever()
# 在新版链中引用
# chain = {"context": retriever, "question": RunnablePassthrough()} | prompt | llm
完整 RAG 实战示例
下面我们来实现一个完整的 RAG 应用。首先需要安装额外依赖:
pip install langchain-community faiss-cpu sentence-transformers -i https://mirrors.aliyun.com/pypi/simple/实例
import os

from dotenv import load_dotenv

from langchain_openai import ChatOpenAI

from langchain_community.embeddings import HuggingFaceEmbeddings

from langchain_core.prompts import ChatPromptTemplate

from langchain_core.output_parsers import StrOutputParser

from langchain_core.runnables import RunnablePassthrough

from langchain_community.vectorstores import FAISS

from langchain.text_splitter import RecursiveCharacterTextSplitter

# 加载环境变量

load_dotenv()

# 初始化模型和 Embedding

llm = ChatOpenAI(

    model=os.getenv('DEEPSEEK_MODEL', 'deepseek-v4-pro'),

    openai_api_key=os.getenv('DEEPSEEK_API_KEY'),

    openai_api_base=os.getenv('DEEPSEEK_BASE_URL', 'https://api.deepseek.com'),

)

# 使用免费的本地 Embedding 模型(首次运行会自动下载)

embeddings = HuggingFaceEmbeddings(

    model_name="sentence-transformers/all-MiniLM-L6-v2"

)

# --- 1. 准备知识文档 ---

# 实际项目中,这些文档可以从文件、网页、数据库等加载

documents = [

    "LangChain 是一个用于构建大语言模型应用的开源框架,由 Harrison Chase 于 2022 年创建。",

    "LangChain 的核心组件包括:模型接口、提示词模板、链、记忆、检索和代理。",

    "LCEL(LangChain Expression Language)是 LangChain 的新一代链构建语法,使用管道符 | 连接各组件。",

    "RAG(检索增强生成)通过在生成前检索相关文档,让 LLM 能回答训练数据之外的问题。",

    "LangGraph 是 LangChain 团队推出的新框架,专门用于构建复杂的多步骤 AI 代理工作流。",

    "LangSmith 是 LangChain 的可观测性平台,用于调试、测试和监控 LLM 应用。",

]

# --- 2. 文本切片 ---

text_splitter = RecursiveCharacterTextSplitter(

    chunk_size=100,

    chunk_overlap=20

)

# 这里文档已经较短,实际场景中长文档会被切成多个片段

texts = text_splitter.create_documents(documents)

# --- 3. 向量化并存入 FAISS ---

vectorstore = FAISS.from_documents(texts, embeddings)

# --- 4. 创建检索器 ---

retriever = vectorstore.as_retriever(search_kwargs={"k": 2})

# --- 5. 构建 RAG 链 ---

rag_prompt = ChatPromptTemplate.from_messages([

    ("system", "你是一个知识助手。根据以下检索到的上下文来回答问题。如果上下文中没有答案,就说你不知道。\n\n上下文:{context}"),

    ("human", "{question}")

])

# 辅助函数:将检索到的文档拼接为字符串

def format_docs(docs):

    return "\n".join(doc.page_content for doc in docs)

rag_chain = (

    {"context": retriever | format_docs, "question": RunnablePassthrough()}

    | rag_prompt

    | llm

    | StrOutputParser()

)

# --- 6. 测试 RAG ---

question = "LangChain 的核心组件有哪些?"

print(f"问题:{question}")

print(f"回答:{rag_chain.invoke(question)}")
RAG 技术要点说明:
- FAISS 是 Facebook 开源的向量相似度搜索库,适合本地开发测试,数据存储在内存中
- 生产环境 建议使用 Pinecone、Milvus、Chroma、Weaviate 等专业向量数据库,支持持久化和分布式
- Embedding 模型:本示例使用 HuggingFace 的
all-MiniLM-L6-v2模型,首次运行会自动下载(约 80MB) - 如果你有 OpenAI API Key,也可以使用
OpenAIEmbeddings获得更好的中文效果 - 国内中文场景推荐使用
BAAI/bge-small-zh-v1.5等中文 Embedding 模型 - chunk_size 和 chunk_overlap 需要根据实际文档特点调优,过大可能丢失精度,过小可能丢失上下文
5. 记忆 (Memory)
重要更新: 传统的 ConversationBufferMemory 在复杂的 LCEL 链中较难集成。最新推荐使用 ChatMessageHistory 配合 RunnableWithMessageHistory。
- 核心逻辑: 记忆不再是链的一个属性,而是一个独立的消息存储库,通过
session_id区分不同用户。 - 持久化: 支持存入 Redis、PostgreSQL 或内存。
6. 代理 (Agents)
代理(Agent)是 LangChain 最强大的功能之一。与链(Chain)不同,代理可以根据用户输入自主决策调用哪些工具、以什么顺序执行,是真正的"智能体"。
Agent 的核心循环:接收任务 -> 思考(选择工具)-> 执行工具 -> 观察结果 -> 继续思考或给出最终答案。
用户输入 Agent 决策循环 思考/推理 LLM 分析任务 选择工具 决定调用哪个 执行工具 调用并获取结果 观察结果 分析工具返回 需要更多 信息 最终答案 任务完成 任务完成
使用 @tool 装饰器可以将任何 Python 函数转为 LLM 可调用的工具。LangChain 会自动将函数名和 docstring 传递给模型,让模型知道何时以及如何使用这个工具。
下面是一个完整的 Agent 实战示例,包含天气查询、数学计算和知识搜索三个工具:
实例
import os

from dotenv import load_dotenv

from langchain_openai import ChatOpenAI

from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder

from langchain_core.tools import tool

from langchain.agents import AgentExecutor, create_tool_calling_agent

# 加载环境变量

load_dotenv()

# 初始化 DeepSeek 模型

llm = ChatOpenAI(

    model=os.getenv('DEEPSEEK_MODEL', 'deepseek-v4-pro'),

    openai_api_key=os.getenv('DEEPSEEK_API_KEY'),

    openai_api_base=os.getenv('DEEPSEEK_BASE_URL', 'https://api.deepseek.com'),

)

# --- 定义工具 ---

# 使用 @tool 装饰器,LangChain 会自动将函数名和 docstring 告知模型

@tool

def get_current_weather(city: str) -> str:

    """获取指定城市的当前天气信息。当用户询问天气时使用此工具。"""

    # 实际应用中,这里会调用真实的天气 API

    weather_data = {

        "北京": "晴天,气温 28°C,湿度 45%",

        "上海": "多云,气温 25°C,湿度 70%",

        "深圳": "雷阵雨,气温 30°C,湿度 85%",

    }

    return weather_data.get(city, f"抱歉,暂无 {city} 的天气数据")

@tool

def calculate(expression: str) -> str:

    """计算数学表达式。当用户需要进行数学计算时使用此工具。

    支持基本的四则运算,如 '2 + 3 * 4'。"""

    import ast

    import operator


    # 安全的运算符映射

    ops = {

        ast.Add: operator.add,

        ast.Sub: operator.sub,

        ast.Mult: operator.mul,

        ast.Div: operator.truediv,

        ast.Pow: operator.pow,

        ast.USub: operator.neg,

    }


    def safe_eval(node):

        if isinstance(node, ast.Expression):

            return safe_eval(node.body)

        elif isinstance(node, ast.Constant):

            return node.value

        elif isinstance(node, ast.BinOp):

            left = safe_eval(node.left)

            right = safe_eval(node.right)

            return ops[type(node.op)](left, right)

        elif isinstance(node, ast.UnaryOp):

            operand = safe_eval(node.operand)

            return ops[type(node.op)](operand)

        else:

            raise ValueError(f"不支持的表达式类型: {type(node)}")


    try:

        tree = ast.parse(expression, mode='eval')

        result = safe_eval(tree)

        return f"计算结果:{expression} = {result}"

    except Exception as e:

        return f"计算错误:{e}"

@tool

def search_knowledge(query: str) -> str:

    """搜索知识库获取相关信息。当用户询问事实性问题时使用此工具。"""

    # 实际应用中,这里会连接向量数据库或搜索引擎

    knowledge = {

        "LangChain": "LangChain 是一个用于构建 LLM 应用的开源框架,支持链式调用、记忆管理和工具集成。",

        "Python": "Python 是一种高级编程语言,以简洁易读著称,广泛用于 AI、数据科学等领域。",

    }

    for key, value in knowledge.items():

        if key.lower() in query.lower():

            return value

    return f"未找到与 '{query}' 相关的信息"

# --- 组装工具列表 ---

tools = [get_current_weather, calculate, search_knowledge]

# --- 创建 Agent 的提示词 ---

prompt = ChatPromptTemplate.from_messages([

    ("system", "你是一个功能强大的 AI 助手,可以使用工具来帮助用户。根据用户的问题,判断是否需要使用工具,选择最合适的工具来获取信息。"),

    ("human", "{input}"),

    MessagesPlaceholder(variable_name="agent_scratchpad"),

])

# --- 创建 Agent ---

agent = create_tool_calling_agent(llm, tools, prompt)

# --- 创建 AgentExecutor(代理执行器)---

# verbose=True 可以看到 Agent 的完整思考过程

agent_executor = AgentExecutor(agent=agent, tools=tools, verbose=True)

# --- 测试 Agent ---

# 测试 1:天气查询

print("=" * 50)

response = agent_executor.invoke({"input": "北京今天天气怎么样?"})

print(f"\n最终回答: {response['output']}")

# 测试 2:数学计算

print("\n" + "=" * 50)

response = agent_executor.invoke({"input": "帮我算一下 (15 * 37 + 228) / 3 等于多少"})

print(f"\n最终回答: {response['output']}")

# 测试 3:综合问题(Agent 需要自己判断用哪个工具)

print("\n" + "=" * 50)

response = agent_executor.invoke({"input": "LangChain 是什么?另外帮我算下 2 的 10 次方"})

print(f"\n最终回答: {response['output']}")运行上述代码,你会看到(verbose=True 时的思考链输出):
==================================================

> Entering new AgentExecutor chain...
Invoking: `get_current_weather` with `{'city': '北京'}`

晴天,气温 28°C,湿度 45%

根据查询结果,北京今天的天气是晴天,气温 28°C,湿度 45%。

> Finished chain.

最终回答: 北京今天天气晴朗,气温 28°C,湿度 45%,适合外出活动。

==================================================

> Entering new AgentExecutor chain...
Invoking: `calculate` with `{'expression': '(15 * 37 + 228) / 3'}`

计算结果:(15 * 37 + 228) / 3 = 261.0

> Finished chain.

最终回答: (15 * 37 + 228) / 3 的计算结果是 261.0

==================================================

> Entering new AgentExecutor chain...
Invoking: `search_knowledge` with `{'query': 'LangChain'}`
Invoking: `calculate` with `{'expression': '2 ** 10'}`

LangChain 是一个用于构建 LLM 应用的开源框架...
计算结果:2 ** 10 = 1024

> Finished chain.

最终回答: LangChain 是一个用于构建 LLM 应用的开源框架,支持链式调用、记忆管理和工具集成。另外,2 的 10 次方等于 1024。
**安全提示:**本示例使用安全的 AST 解析替代了 eval()。在实际项目中,切勿对用户输入直接使用 eval(),这会带来严重的远程代码执行风险。
理解 Agent 的"思考过程":
verbose=True让我们看到 Agent 的完整决策链路,便于调试和理解其行为- Agent 会自动判断需要调用什么工具,不需要人工指定调用顺序
- 如果问题不需要工具(如简单的闲聊),Agent 会直接用自身知识回答
- 对于复杂问题,Agent 可能会多次调用工具,甚至并行调用多个工具
快速开始:构建你的第一个 LangChain 应用
让我们通过一个简单的例子,感受一下 LangChain 的便捷性。
实际的开发中,我们可以把 API 的相关信息保存在项目根目录的 .env 文件中,方便使用。
# .env 文件内容
DEEPSEEK_API_KEY=sk-xxx
DEEPSEEK_BASE_URL=https://api.deepseek.com
DEEPSEEK_MODEL=deepseek-v4-pro
使用 LangChain 的 ChatOpenAI 时,openai_api_base 建议配置为 https://api.deepseek.com,无需手动加 /v1,LangChain 会自动拼接路径。
示例 1:基础问答链
实例
import os

from dotenv import load_dotenv

# 正确的导入路径

from langchain_core.prompts import PromptTemplate

from langchain_core.output_parsers import StrOutputParser

from langchain_openai import ChatOpenAI

# 加载环境变量

load_dotenv()

llm = ChatOpenAI(

    model=os.getenv('DEEPSEEK_MODEL'),

    openai_api_key=os.getenv('DEEPSEEK_API_KEY'),

    openai_api_base=os.getenv('DEEPSEEK_BASE_URL'),

)

# 创建提示词模板

template = """

你是一位友好的助手。

请回答以下问题:

问题:{question}

回答:

"""

prompt = PromptTemplate.from_template(template)

# 使用 LCEL 语法创建链 (推荐方式)

# 结构:Prompt -> LLM -> 解析为字符串

chain = prompt | llm | StrOutputParser()

# 运行链

question = "LangChain 是什么?它有什么主要用途?"

response = chain.invoke({"question": question})

print("问题:", question)

print("-" * 20)

print("回答:", response)
示例 2:带记忆的对话链
让我们创建一个能记住对话历史的简单聊天机器人。
实例
import os

from dotenv import load_dotenv

from langchain_openai import ChatOpenAI

from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder

from langchain_community.chat_message_histories import ChatMessageHistory

from langchain_core.chat_history import BaseChatMessageHistory

from langchain_core.runnables.history import RunnableWithMessageHistory

# 1. 加载配置

load_dotenv()

# 2. 初始化 DeepSeek 模型

llm = ChatOpenAI(

    model=os.getenv('DEEPSEEK_MODEL', 'deepseek-v4-pro'),

    openai_api_key=os.getenv('DEEPSEEK_API_KEY'),

    openai_api_base=os.getenv('DEEPSEEK_BASE_URL', 'https://api.deepseek.com'),

)

# 3. 定义提示词模板

# MessagesPlaceholder 会在运行时被对话历史填充

prompt = ChatPromptTemplate.from_messages([

    ("system", "你是一个乐于助人的 AI 助手。"),

    MessagesPlaceholder(variable_name="history"),

    ("human", "{question}"),

])

# 4. 构建链

chain = prompt | llm

# 5. 管理内存:创建一个字典来存储不同用户的历史记录

store = {}

def get_session_history(session_id: str) -> BaseChatMessageHistory:

    if session_id not in store:

        store[session_id] = ChatMessageHistory()

    return store[session_id]

# 6. 使用 RunnableWithMessageHistory 包装我们的链

# 这样 LangChain 会自动处理历史记录的读取和更新

with_message_history = RunnableWithMessageHistory(

    chain,

    get_session_history,

    input_messages_key="question",

    history_messages_key="history",

)

# 7. 进入对话循环

print("--- 已进入 DeepSeek 聊天模式 (输入 'exit' 退出) ---")

session_config = {"configurable": {"session_id": "user_001"}} # 区分不同会话的 ID

while True:

    user_input = input("你: ")

    if user_input.lower() in ["exit", "quit", "退出"]:

        break


    # 调用带记忆的链

    response = with_message_history.invoke(

        {"question": user_input},

        config=session_config

    )


print(f"AI: {response.content}\n")运行上述代码,你会看到:
--- 已进入 DeepSeek 聊天模式 (输入 'exit' 退出) ---
你: 你好
AI: 你好!很高兴见到你! 有什么我可以帮助你的吗?无论是回答问题、聊天,还是协助解决问题,我都很乐意为你提供帮助!

你: 我叫小明
AI: 你好,小明!很高兴认识你!
如果你有任何问题、想法,或者需要帮助的地方,随时告诉我哦~

你: 我叫什么记得吗?
AI: 当然记得!你刚刚告诉我你叫**小明**~
我会认真记住我们的对话内容,在之后的交流中尽量保持上下文连贯。不过如果对话过长或间隔太久,我可能需要你提醒一下哦~
有什么想聊的或需要帮助的吗?
总结
本文介绍了 LangChain 框架的核心概念和实战应用。LangChain 通过标准化的组件和链式调用,让开发者能够快速构建功能强大的 AI 应用。
下表总结了本文涉及的核心知识点:
| 概念 | 说明 | 关键代码 |
|---|---|---|
| LCEL 链 | 用管道符 | 连接 Prompt、Model、Parser |
| 提示词模板 | 结构化的 Prompt,区分 system/user 角色 | ChatPromptTemplate.from_messages() |
| 流式输出 | 逐字输出,提升用户体验 | chain.stream() |
| 对话记忆 | 通过 session_id 管理多轮对话历史 | RunnableWithMessageHistory |
| RAG 检索增强 | 外部知识接入,突破 LLM 知识边界 | `retriever |
| Agent 智能体 | 自主决策调用工具,最核心的高级功能 | create_tool_calling_agent() |
推荐学习路径
LangChain 基础 LCEL 链 RAG 应用 Agent 智能体 LangGraph 工作流 LangSmith 监控
AI 思考中...