Deep Agents 入门教程
Deep Agents 是 LangChain 官方推出的一套开箱即用(Batteries Included)的 Agent 开发框架,专门面向复杂任务、长流程执行、多步骤规划以及多 Agent 协作场景而设计。
相比传统 Agent 需要开发者自行组合 Prompt、Tool、Memory、Workflow 等组件,Deep Agents 已经内置了任务规划、文件系统、子 Agent 调度、上下文压缩、记忆管理等核心能力,让开发者能够将更多精力放在业务逻辑上,而不是底层架构搭建。
本教程面向零基础开发者,带你从安装配置开始,逐步了解 Deep Agents 的核心工作机制,并使用 DeepSeek API 构建一个真实可运行的 AI Agent 项目。
什么是 Deep Agents
Deep Agents 可以理解为一个面向生产环境的高级 Agent 框架(Agent Harness)。
官方将其定义为:一个具备完整基础设施的 Agent 运行框架,而不仅仅是一个简单的 LLM + Tool 调用循环。
安装完成后,即可直接获得以下能力,无需额外开发:
- 自动任务规划(Planning)
- 文件系统读写(Filesystem)
- 子 Agent 协作(Sub Agents)
- 上下文压缩与管理(Context Management)
- 长任务执行(Long Running Tasks)
- 人工审批(Human-in-the-Loop)
- 持久化记忆(Memory)
- 流式输出(Streaming)
Deep Agents 的设计目标
传统 Agent 通常采用 ReAct 模式:用户输入 → LLM 推理 → 调用工具 → LLM 推理 → 调用工具 → 输出结果。
当任务规模较小时,这种模式运行良好。但随着任务复杂度提升(例如自动生成市场调研报告、分析多家公司财报、编写完整项目代码),就会逐渐暴露出以下问题:
- 上下文窗口迅速膨胀,超出模型限制
- 推理链过长导致性能下降
- Agent 容易遗忘之前完成的工作
- 多任务之间缺乏隔离,相互干扰
- Tool 调用逻辑越来越复杂,难以维护
Deep Agents 的核心目标,就是解决这些复杂任务场景下的工程化问题。
与 LangChain、LangGraph 的关系
很多初学者容易混淆这三个项目的定位,它们实际上处于不同的抽象层级。
| 框架 | 层级定位 | 核心职责 | 适用场景 |
|---|---|---|---|
| LangChain | 基础组件层 | 提供 Model、Prompt、Tool、Retriever、Output Parser 等 AI 基础组件 | 构建单个 Agent 或 AI 应用的基础能力 |
| LangGraph | 运行时层 | 提供状态管理、工作流编排、节点与边、Checkpoint 持久化能力 | 需要自定义图结构和执行流程的复杂场景 |
| Deep Agents | 应用框架层 | 在 LangGraph 之上封装规划、文件系统、子 Agent、记忆、上下文压缩等生产级能力 | 快速构建复杂多步骤 Agent,无需从头设计架构 |
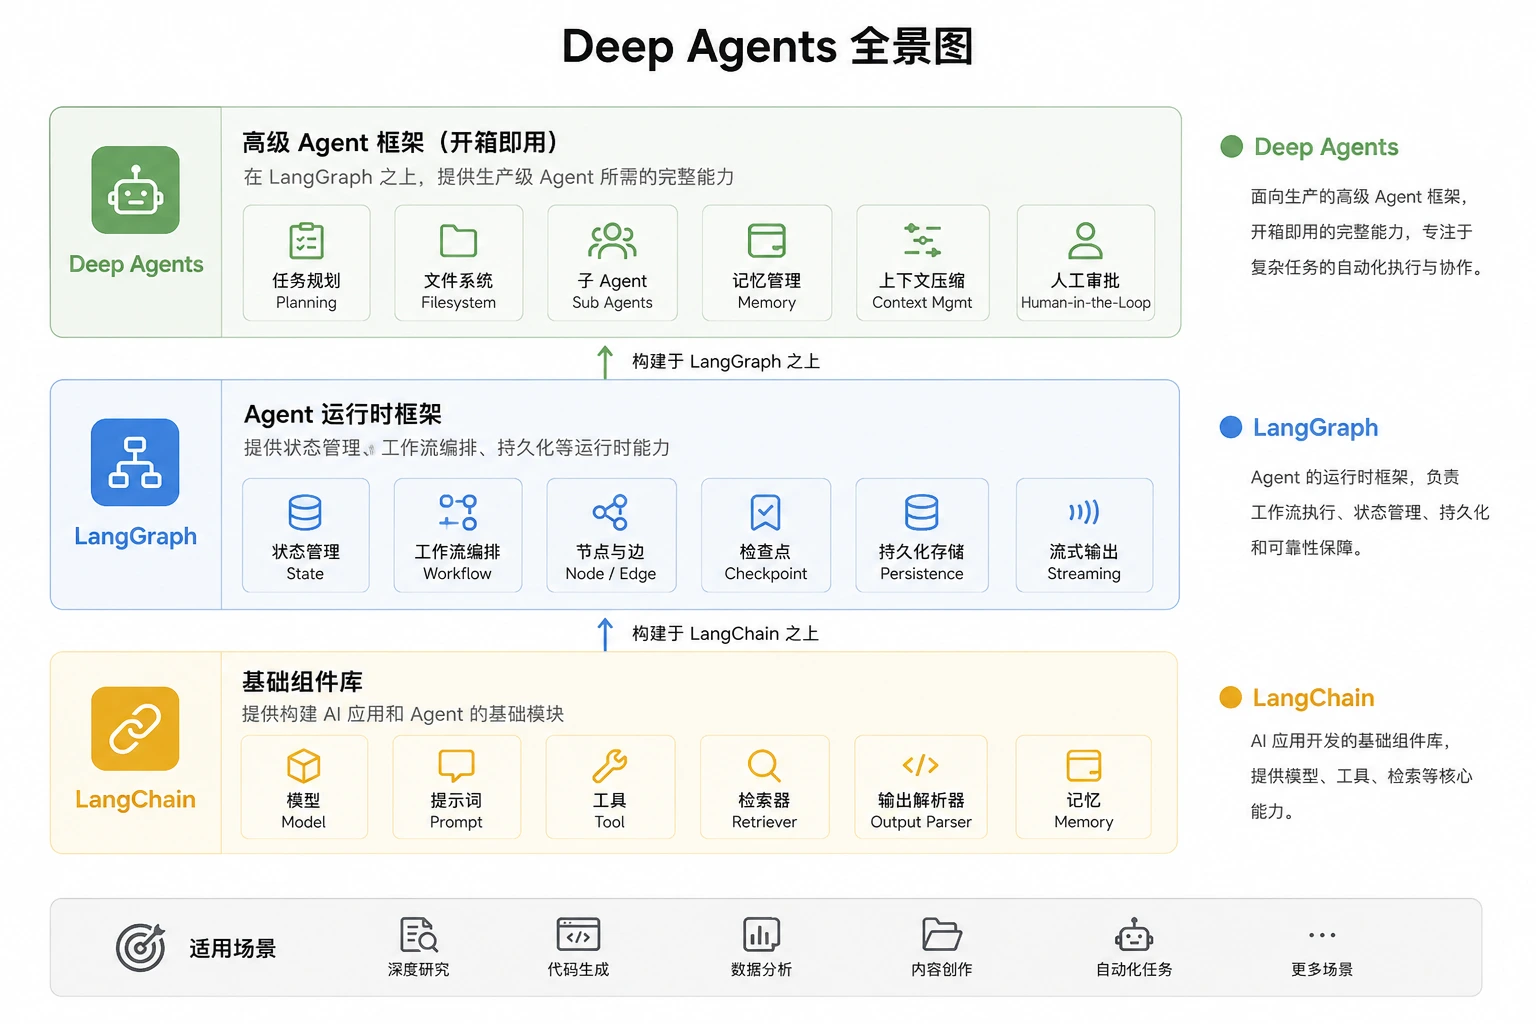
三者并非相互替代,而是可以协同使用:LangChain 提供积木,LangGraph 是组织积木的工程框架,Deep Agents 是在此之上开箱即用的高级应用层。任何一个 LangGraph
CompiledStateGraph都可以作为 subagent 传入 Deep Agents,三层可以灵活混用。
核心能力一览
Deep Agents 内置以下中间件,无需额外配置即可使用:
| 能力 | 说明 | 核心组件 |
|---|---|---|
| 任务规划 | 用内置 write_todos 工具将复杂任务分解为有序步骤 | TodoListMiddleware |
| 虚拟文件系统 | 读写文件、将大型工具输出卸载到磁盘,节省上下文窗口 | FilesystemMiddleware |
| 子 Agent | 将子任务委派给独立上下文窗口的专用子 Agent | SubAgentMiddleware |
| 上下文压缩 | 自动总结历史消息,避免超出模型上下文限制 | SummarizationMiddleware |
| Human-in-the-loop | 在关键工具调用前暂停,等待人工审批 | HumanInTheLoopMiddleware |
| 长期记忆 | 跨会话持久化记忆,基于 LangGraph Store | MemoryMiddleware |
| Skills | 按需加载可复用的领域知识与指令集 | SkillsMiddleware |
安装
Deep Agents 发布在 PyPI,包名为 deepagents。
推荐使用 uv 安装,速度更快;也可以使用传统的 pip。
使用 uv 安装(推荐)
uv init
uv add deepagents tavily-python
uv sync
使用 pip 安装
pip install deepagents tavily-python搭配 DeepSeek API 安装
DeepSeek 兼容 OpenAI 接口,因此需要同时安装 langchain-openai。
pip install deepagents langchain-openaiDeep Agents 对模型的唯一要求是:该模型支持 tool calling(工具调用)。DeepSeek V3 和 DeepSeek R1 系列均支持,可放心使用。
配置说明
create_deep_agent 是创建 Agent 的核心函数,支持以下参数配置。
| 参数 | 类型 | 是否必填 | 说明 | 默认值 |
|---|---|---|---|---|
model | str 或模型实例 | 否 | 模型字符串,格式为 provider:model-name,或直接传入初始化好的模型对象 | anthropic:claude-sonnet-4-6 |
tools | 列表 | 否 | 自定义工具函数或 LangChain Tool 对象的列表 | None |
system_prompt | str 或 SystemMessage | 否 | 自定义系统提示词,用于定义 Agent 角色和行为 | None |
backend | BackendProtocol | 否 | 虚拟文件系统后端,决定文件存储位置 | StateBackend |
subagents | 列表 | 否 | 子 Agent 定义列表,用于任务委派 | None |
memory | 列表 | 否 | 启动时加载的 AGENTS.md 文件路径列表 | None |
skills | 列表 | 否 | 按需加载的 Skills 目录路径列表 | None |
permissions | 列表 | 否 | 文件系统路径级别的访问权限控制规则 | None |
interrupt_on | dict | 否 | 指定哪些工具调用需要人工审批,需配合 checkpointer 使用 | None |
checkpointer | Checkpointer | 否 | 状态持久化检查点,多轮对话或 HITL 时必须设置 | None |
store | BaseStore | 否 | 跨会话的长期存储后端 | None |
response_format | ResponseFormat | 否 | 结构化输出的 Schema 定义 | None |
middleware | 列表 | 否 | 追加到默认中间件栈末尾的自定义中间件 | () |
debug | bool | 否 | 开启调试模式,输出详细日志 | False |
文件系统后端对比
Deep Agents 提供多种后端,用来控制 Agent 如何读写文件。
| 后端 | 存储位置 | 跨会话持久化 | 适用场景 |
|---|---|---|---|
| StateBackend | LangGraph 图状态内 | 否(同线程内有效) | 默认,本地开发和简单场景 |
| FilesystemBackend | 本机磁盘 | 是 | 需要真实读写本地文件,需谨慎使用 |
| StoreBackend | LangGraph Store | 是 | 多轮对话持久化、跨 Thread 共享 |
| LocalShellBackend | 本机磁盘 + Shell | 是 | 需要执行 Shell 命令,仅限受信任环境 |
| CompositeBackend | 路由到多个后端 | 取决于子后端 | 精细控制不同目录的存储策略 |
初学者直接使用默认的 StateBackend 即可。FilesystemBackend 和 LocalShellBackend 会让 Agent 直接操作你的本地文件系统,需要严格配置权限后再使用。
快速开始
本节演示如何用最少的代码创建一个可以运行的 Deep Agent。
配置 DeepSeek API Key
DeepSeek 兼容 OpenAI 的接口格式,需要同时设置 API Key 和 Base URL。
export OPENAI_API_KEY="sk-your-deepseek-api-key"
export OPENAI_BASE_URL="https://api.deepseek.com"
export TAVILY_API_KEY="your-tavily-api-key"
DeepSeek 的 API Key 可在 platform.deepseek.com 申请。将环境变量
OPENAI_BASE_URL指向 DeepSeek 的地址,LangChain 会自动将请求转发过去。TAVILY_API_KEY 需要到 Tavily 官方网站 https://www.tavily.com/ 申请,生成的 tvly-xxxxxxxx 格式密钥。
最简示例:Hello World Agent
创建一个带自定义工具的 Agent,向 DeepSeek 发送第一条消息。
实例
# 文件路径:hello_agent.py

import os

from deepagents import create_deep_agent

from langchain_openai import ChatOpenAI

# 使用 ChatOpenAI 并将 base_url 指向 DeepSeek,这是最直接的接入方式

model = ChatOpenAI(

    model="deepseek-v4-flash",           # 必填:模型名称

    api_key=os.environ["OPENAI_API_KEY"],   # 必填:DeepSeek API Key

    base_url="https://api.deepseek.com",    # 必填:DeepSeek 的 OpenAI 兼容端点

)

# 定义一个简单的自定义工具,函数的 docstring 就是工具描述

def get_weather(city: str) -> str:

    """查询指定城市的天气。"""

    # 实际项目中这里会调用真实天气 API

    return f"{city} 今天晴天,气温 25°C,适合出行。"

# 创建 Agent,传入模型实例和工具列表

agent = create_deep_agent(

    model=model,

    tools=[get_weather],

    system_prompt="你是一个友好的助手,能够查询天气信息。",

)

# 调用 Agent,messages 接受 OpenAI 风格的消息格式

result = agent.invoke({

    "messages": [{"role": "user", "content": "北京今天天气怎么样?"}]

})

# 打印 Agent 的最终回复

print(result["messages"][-1].content)# 运行脚本
python hello_agent.py输出内容:
北京今天**晴天**,气温 **25°C**,非常适合出行。☀️
注意:Agent 返回的是完整的消息列表(
messages),最终回复位于列表末尾,即result["messages"][-1].content。
详细用法
本节通过几个真实场景,逐步展示 Deep Agents 的核心能力。
使用 DeepSeek R1 进行推理任务
DeepSeek R1 是推理增强模型,适合需要复杂分析的任务。
实例
# 文件路径:reasoning_agent.py

import os

from deepagents import create_deep_agent

from langchain_openai import ChatOpenAI

# DeepSeek R1:专为复杂推理设计的模型

model = ChatOpenAI(

    model="deepseek-v4-pro",           # DeepSeek 思考模型

    api_key=os.environ["OPENAI_API_KEY"],

    base_url="https://api.deepseek.com",

)

# 数学计算工具示例

def calculate(expression: str) -> str:

    """对数学表达式进行安全求值,返回计算结果。"""

    try:

        # 注意:生产环境中应使用更安全的表达式求值库

        result = eval(expression, {"__builtins__": {}}, {})

        return f"计算结果:{expression} = {result}"

    except Exception as e:

        return f"计算出错:{str(e)}"

agent = create_deep_agent(

    model=model,

    tools=[calculate],

    system_prompt="你是一位数学分析专家,善于分解复杂问题并逐步求解。",

)

result = agent.invoke({

    "messages": [{"role": "user", "content": "计算 1 到 100 的所有奇数之和,并验证结果。"}]

})

print(result["messages"][-1].content)
执行输出:
再换一种方法做交叉验证:

- 1 到 100 所有整数之和:\( \frac{100 \times 101}{2} = 5050 \)
- 1 到 100 的偶数之和:\( 2 + 4 + \cdots + 100 = 2 \times \frac{50 \times 51}{2} = 2550 \)
- 奇数之和:\( 5050 - 2550 = 2500 \)

两种方法结果一致。

---

**结论**:1 到 100 的所有奇数之和为 **2500**。

**推导回顾**:
- 奇数序列首项 1,末项 99,项数 \( \frac{99-1}{2}+1 = 50 \)
- 等差数列求和:\( S = \frac{n(a_1 + a_n)}{2} = \frac{50 \times (1+99)}{2} = 2500 \)
自定义系统提示词
通过 system_prompt 参数定义 Agent 的角色、任务目标和行为规范。
实例
# 文件路径:custom_prompt_agent.py

import os

from deepagents import create_deep_agent

from langchain_openai import ChatOpenAI

model = ChatOpenAI(

    model="deepseek-v4-flash",

    api_key=os.environ["OPENAI_API_KEY"],

    base_url="https://api.deepseek.com",

)

# 自定义系统提示词:明确 Agent 的身份、职责和行为准则

code_review_instructions = """你是一位资深 Python 工程师,专注于代码审查。

你的职责:

- 检查代码的可读性、性能、安全性

- 指出潜在的 Bug 和改进建议

- 提供具体的修改示例

回复格式:

1. 总体评分(1-10)

2. 主要问题列表

3. 具体改进建议(附修改后的代码片段)

"""

agent = create_deep_agent(

    model=model,

    system_prompt=code_review_instructions,

)

# 提交一段待审查的代码

code_to_review = """

def find_user(users, name):

    for i in range(len(users)):

        if users[i]['name'] == name:

            return users[i]

    return None

"""

result = agent.invoke({

    "messages": [{"role": "user", "content": f"请审查以下代码:\n```python{code_to_review}```"}]

})

print(result["messages"][-1].content)
流式输出
对于需要实时展示进度的场景,可以使用 stream 方法逐块接收 Agent 输出。
实例
# 文件路径:streaming_agent.py

import os

from deepagents import create_deep_agent

from langchain_openai import ChatOpenAI

model = ChatOpenAI(

    model="deepseek-v4-flash",

    api_key=os.environ["OPENAI_API_KEY"],

    base_url="https://api.deepseek.com",

)

agent = create_deep_agent(

    model=model,

    system_prompt="你是一位技术写作专家,擅长写清晰易懂的技术文档。",

)

# stream 方法返回生成器,每次 yield 一个事件块

for chunk in agent.stream({

    "messages": [{"role": "user", "content": "写一篇关于 Python 装饰器的简短介绍。"}]

}):

    # chunk 是一个包含增量消息的字典

    if "messages" in chunk:

        for msg in chunk["messages"]:

            if hasattr(msg, "content") and msg.content:

                print(msg.content, end="", flush=True)

print()  # 最终换行
多轮对话(带检查点)
配合 MemorySaver 检查点,可以实现跨轮次的有状态对话。
实例
# 文件路径:multi_turn_agent.py

import os

from deepagents import create_deep_agent

from langchain_openai import ChatOpenAI

from langgraph.checkpoint.memory import MemorySaver  # 内存检查点,重启后数据会丢失

model = ChatOpenAI(

    model="deepseek-v4-flash",

    api_key=os.environ["OPENAI_API_KEY"],

    base_url="https://api.deepseek.com",

)

# MemorySaver 将对话状态保存在内存中,进程结束后丢失

# 生产环境建议使用 SqliteSaver 或 PostgresSaver

checkpointer = MemorySaver()

agent = create_deep_agent(

    model=model,

    system_prompt="你是一个乐于助人的编程助手。",

    checkpointer=checkpointer,  # 必须传入,否则多轮对话无法记忆上下文

)

# thread_id 是对话线程的唯一标识,同一 thread_id 共享同一上下文

config = {"configurable": {"thread_id": "runoob-session-001"}}

# 第一轮

result1 = agent.invoke(

    {"messages": [{"role": "user", "content": "我叫 RUNOOB,我在学习 Python。"}]},

    config=config,

)

print("第一轮回复:", result1["messages"][-1].content)

# 第二轮:Agent 能记住上一轮的信息

result2 = agent.invoke(

    {"messages": [{"role": "user", "content": "我叫什么名字?我在学什么?"}]},

    config=config,

)

print("第二轮回复:", result2["messages"][-1].content)第一轮回复:你好,RUNOOB!很高兴认识你,Python 是一门非常适合初学者的语言...
第二轮回复:你叫 RUNOOB,你正在学习 Python!...**thread_id 的作用:**同一个
thread_id下的所有调用共享同一段对话历史。不同的thread_id之间相互隔离,互不干扰。可以把它理解为"对话房间号"。
综合 Demo:研究报告 Agent
本节展示一个完整的研究报告 Agent,使用 DeepSeek V3 作为主模型,集成自定义搜索工具,并演示子 Agent 的使用。
场景说明
我们将构建一个 Agent,接收用户的研究主题,自动分解任务、调用搜索工具收集资料,最终输出一份结构化报告。
实例
# 文件路径:research_agent_demo.py

# 演示:使用 DeepSeek API + Deep Agents 构建研究报告 Agent

# 依赖安装:pip install deepagents langchain-openai requests

import os

import json

from tavily import TavilyClient

from typing import Literal

from deepagents import create_deep_agent

from langchain_openai import ChatOpenAI

from langgraph.checkpoint.memory import MemorySaver

# ──────────────────────────────────────────

# 1. 初始化 DeepSeek 模型

# ──────────────────────────────────────────

main_model = ChatOpenAI(

    model="deepseek-v4-flash",            # 综合能力强,适合规划和写作

    api_key=os.environ["OPENAI_API_KEY"],

    base_url="https://api.deepseek.com",

    temperature=0.3,                  # 可选:降低随机性,使报告更严谨

)

# 初始化 Tavily 客户端(用于搜索工具)

tavily_client = TavilyClient(

    api_key=os.environ["TAVILY_API_KEY"]

)

# ──────────────────────────────────────────

# 2. 定义搜索工具 Tavily

# ──────────────────────────────────────────

def web_search(

    query: str,

    max_results: int = 5,

) -> str:

    """使用 Tavily 搜索互联网信息"""

    try:

        response = tavily_client.search(

            query=query,

            max_results=max_results,

            search_depth="advanced",

            include_answer=True,

            include_raw_content=False,

        )

        lines = []

        # AI 总结答案

        if response.get("answer"):

            lines.append(f"总结:{response['answer']}\n")

        # 搜索结果

        for idx, item in enumerate(response.get("results", []), start=1):

            lines.append(

                f"""

[{idx}] {item.get('title', '')}

URL: {item.get('url', '')}

内容: {item.get('content', '')}

""".strip()

            )

        return "\n\n".join(lines)

def format_report(title: str, sections: str) -> str:

    """将研究内容整理为 Markdown 格式的报告。

    Args:

        title: 报告标题

        sections: 各章节内容,以 JSON 字符串表示,格式:{"章节名": "内容"}

    """

    try:

        data = json.loads(sections)

        lines = [f"# {title}\n"]

        for section_name, content in data.items():

            lines.append(f"## {section_name}\n")

            lines.append(f"{content}\n")

        return "\n".join(lines)

    except Exception as e:

        return f"格式化出错:{str(e)}"

# ──────────────────────────────────────────

# 3. 定义专用子 Agent(信息整合专家)

#    子 Agent 有独立的上下文窗口,避免主 Agent 上下文膨胀

# ──────────────────────────────────────────

report_writer_subagent = {

    "name": "report-writer",                        # 必填:子 Agent 唯一名称

    "description": "专业的报告撰写助手,负责将研究资料整合为结构清晰的报告。",  # 必填:主 Agent 用此描述决定何时委派任务

    "system_prompt": "你是一位专业的报告撰写专家。接收研究资料后,请整理成包含摘要、主要内容、结论三部分的报告,语言简洁清晰。",

    "tools": [format_report],                       # 可选:子 Agent 专用工具

    # 不指定 model 则继承主 Agent 的模型

}

# ──────────────────────────────────────────

# 4. 配置并创建 Deep Agent

# ──────────────────────────────────────────

checkpointer = MemorySaver()

research_instructions = """你是一位专业的研究助手,擅长深度调研和报告撰写。

当用户提供研究主题时,你应当:

1. 使用 web_search 工具搜索相关信息(至少搜索 2-3 次,涵盖不同角度)

2. 将收集到的资料整理汇总

3. 委派 report-writer 子 Agent 撰写最终报告

4. 输出完整报告给用户

注意:每次搜索使用不同的关键词,以获取更全面的信息。

"""

agent = create_deep_agent(

    model=main_model,

    tools=[web_search],                 # 主 Agent 可用的工具

    system_prompt=research_instructions,

    subagents=[report_writer_subagent], # 注册子 Agent

    checkpointer=checkpointer,

)

# ──────────────────────────────────────────

# 5. 运行 Agent

# ──────────────────────────────────────────

print("正在研究中,请稍候...\n")

result = agent.invoke(

    {

        "messages": [{

            "role": "user",

            "content": "请帮我研究 LangGraph 是什么,以及它的主要应用场景。"

        }]

    },

    config={"configurable": {"thread_id": "runoob-research-001"}}

)

print("=" * 60)

print("研究报告")

print("=" * 60)

print(result["messages"][-1].content)正在研究中,请稍候...
============================================================
研究报告
============================================================
# LangGraph 研究报告
## 摘要
LangGraph 是 LangChain 团队推出的一个用于构建有状态、多角色 LLM 应用的框架...
## 主要内容
### 核心概念
LangGraph 将 Agent 的执行流程建模为一张有向图...
### 主要应用场景
1. 多步骤推理任务
2. 人机协作(Human-in-the-loop)工作流
3. 多 Agent 协作系统
...
## 结论
LangGraph 是构建生产级 Agent 应用的重要工具...Human-in-the-loop 示例
对于敏感操作(例如删除文件、发送邮件),可以配置 Agent 在执行前暂停等待人工确认。
实例
# 文件路径:hitl_agent.py

# Human-in-the-loop:让 Agent 在执行危险操作前请求人工审批

import os

from langchain.tools import tool

from deepagents import create_deep_agent

from langchain_openai import ChatOpenAI

from langgraph.checkpoint.memory import MemorySaver

from langgraph.types import Command

model = ChatOpenAI(

    model="deepseek-v4-flash",

    api_key=os.environ["OPENAI_API_KEY"],

    base_url="https://api.deepseek.com",

)

# 使用 @tool 装饰器定义工具(需要 langchain 包)

@tool

def delete_file(path: str) -> str:

    """删除指定路径的文件。"""

    # 实际项目中这里会调用 os.remove(path)

    return f"文件 {path} 已删除。"

@tool

def read_file(path: str) -> str:

    """读取指定路径的文件内容。"""

    return f"文件 {path} 的内容:(示例内容)"

# interrupt_on 配置哪些工具需要人工审批

# True 表示允许:审批、编辑参数、拒绝、发送自定义回复

# False 表示不需要审批

# dict 可以精细控制允许的操作类型

checkpointer = MemorySaver()  # HITL 必须配合 checkpointer 使用

agent = create_deep_agent(

    model=model,

    tools=[delete_file, read_file],

    interrupt_on={

        "delete_file": True,   # 删除操作:需要完整审批流程

        "read_file": False,    # 读取操作:无需审批

    },

    checkpointer=checkpointer,

)

config = {"configurable": {"thread_id": "runoob-hitl-001"}}

# 第一次调用:Agent 执行到 delete_file 时会暂停

print("启动 Agent...")

result = agent.invoke(

    {"messages": [{"role": "user", "content": "请删除 /tmp/test.txt 文件。"}]},

    config=config,

)

# 检查是否有待审批的中断

for msg in result.get("messages", []):

    print(f"Agent 消息: {msg.content if hasattr(msg, 'content') else msg}")

# 恢复执行:传入审批决定

# "approve" 表示批准执行该工具

# "reject" 表示拒绝,Agent 将不执行该工具

print("\n用户审批:批准删除操作")

final_result = agent.invoke(

    Command(resume={"decision": "approve"}),

    config=config,

)

print("最终结果:", final_result["messages"][-1].content)
**interrupt_on 的工作原理:**当 Agent 即将调用被标记的工具时,LangGraph 会触发一个
interrupt,Agent 的执行暂停。你可以通过Command(resume=...)传入审批结果来恢复执行。
常见问题
以下是使用 Deep Agents 时常见的疑问和注意事项。
如何判断选用 Deep Agents 还是直接用 LangChain/LangGraph?
| 场景 | 推荐选择 | 理由 |
|---|---|---|
| 需要规划、文件读写、子 Agent、上下文压缩 | Deep Agents | 这些能力开箱即用,无需自行组装 |
| 需要轻量封装,只要工具调用循环 | LangChain create_agent | 比 Deep Agents 更轻,没有内置中间件 |
| 需要自定义图结构,循环不是标准的工具调用循环 | LangGraph | 完全自定义图节点和边的逻辑 |
| LangGraph CompiledStateGraph 作为子 Agent | 混用 | 可以将自定义图作为 subagent 传入 Deep Agents |
DeepSeek 模型的选择建议
| 模型 | model 字符串 | 特点 | 适用场景 |
|---|---|---|---|
| deepseek-v4-flash | deepseek-v4-flash | 综合能力强,速度快,价格低 | 通用任务、日常对话、写作 |
| deepseek-v4-pro | deepseek-v4-pro | 推理能力强,内置思维链 | 数学、代码、复杂逻辑推理 |
Agent 调用工具后没有返回结果怎么办?
工具函数的返回值必须是字符串或可序列化为字符串的类型。
如果工具返回复杂对象(如字典、列表),建议用 json.dumps(result, ensure_ascii=False) 转换后再返回。
如何让 Agent 一次只能访问特定文件?
使用 permissions 参数配置文件系统访问权限,可以精确控制 Agent 只能读写指定路径。
实例
from deepagents import create_deep_agent

from deepagents.permissions import FilesystemPermission

from langchain_openai import ChatOpenAI

import os

model = ChatOpenAI(

    model="deepseek-v4-flash",

    api_key=os.environ["OPENAI_API_KEY"],

    base_url="https://api.deepseek.com",

)

agent = create_deep_agent(

    model=model,

    permissions=[

        FilesystemPermission(path="/workspace/", read=True, write=True),   # 允许读写工作目录

        FilesystemPermission(path="/secrets/", read=False, write=False),    # 禁止访问敏感目录

    ],

)
Agent 默认系统提示词和我的提示词如何合并?
Deep Agents 的提示词由四部分按固定顺序拼接:
USER(你的 system_prompt)→ BASE(SDK 默认提示词)→ SUFFIX(模型厂商特定调整)
你的提示词永远在最前面,不会被覆盖。SDK 的默认提示词告诉模型如何使用规划和文件工具,所以大多数情况下不需要自己重写它。
初学者容易犯的错误
**常见错误 1:**忘记传入
checkpointer。使用 Human-in-the-loop(interrupt_on)或多轮对话时,必须传入 checkpointer,否则状态无法保存,Agent 会报错。
**常见错误 2:**工具函数没有写 docstring。Deep Agents 用函数的 docstring 作为工具描述,让模型知道什么时候调用这个工具。没有 docstring 的工具,模型可能不知道何时调用甚至拒绝使用。
**常见错误 3:**在中间件中直接修改
self的属性。Agent 的子 Agent 和并发操作可能同时运行,对中间件实例属性的直接修改会导致竞争条件(race condition)。需要保存状态时,应通过图的 state 来传递,而不是中间件实例变量。
更多资料
更多内容可以参考以下文档:
AI 思考中...