Hugging Face Transformers
Hugging Face Transformers 是目前最流行的开源 NLP / AI 库,提供数千个预训练模型,覆盖文本、图像、音频、多模态等几乎所有 AI 任务。
它的核心价值:把复杂的模型加载、推理、训练流程封装成几行代码。
Hugging Face 生态系统全景 Hub 40万+ 模型 10万+ 数据集 Transformers 预训练模型推理 与微调框架 Datasets 海量数据集 高效加载处理 PEFT 参数高效微调 LoRA / QLoRA Accelerate 多GPU/TPU训练 分布式加速 Tokenizers 高性能分词器(Rust实现) Evaluate 模型评估指标(BLEU/F1等)
支持的任务类型
Transformers 支持的任务分类 NLP 自然语言处理 文本分类(情感分析) 命名实体识别(NER) 问答系统(QA) 文本摘要生成 机器翻译 文本生成(对话) 填空/语言模型 CV 计算机视觉 图像分类 目标检测 图像分割 深度估计 图像生成 视频分类 关键点检测 音频 & 多模态 语音识别(ASR) 音频分类 文本转语音(TTS) 图文匹配(VQA) 图像描述生成 文档问答(DOC QA) 零样本分类
Transformer 架构核心原理
在使用库之前,理解底层架构会让你知道为什么这样调参。
整体架构:Encoder-Decoder
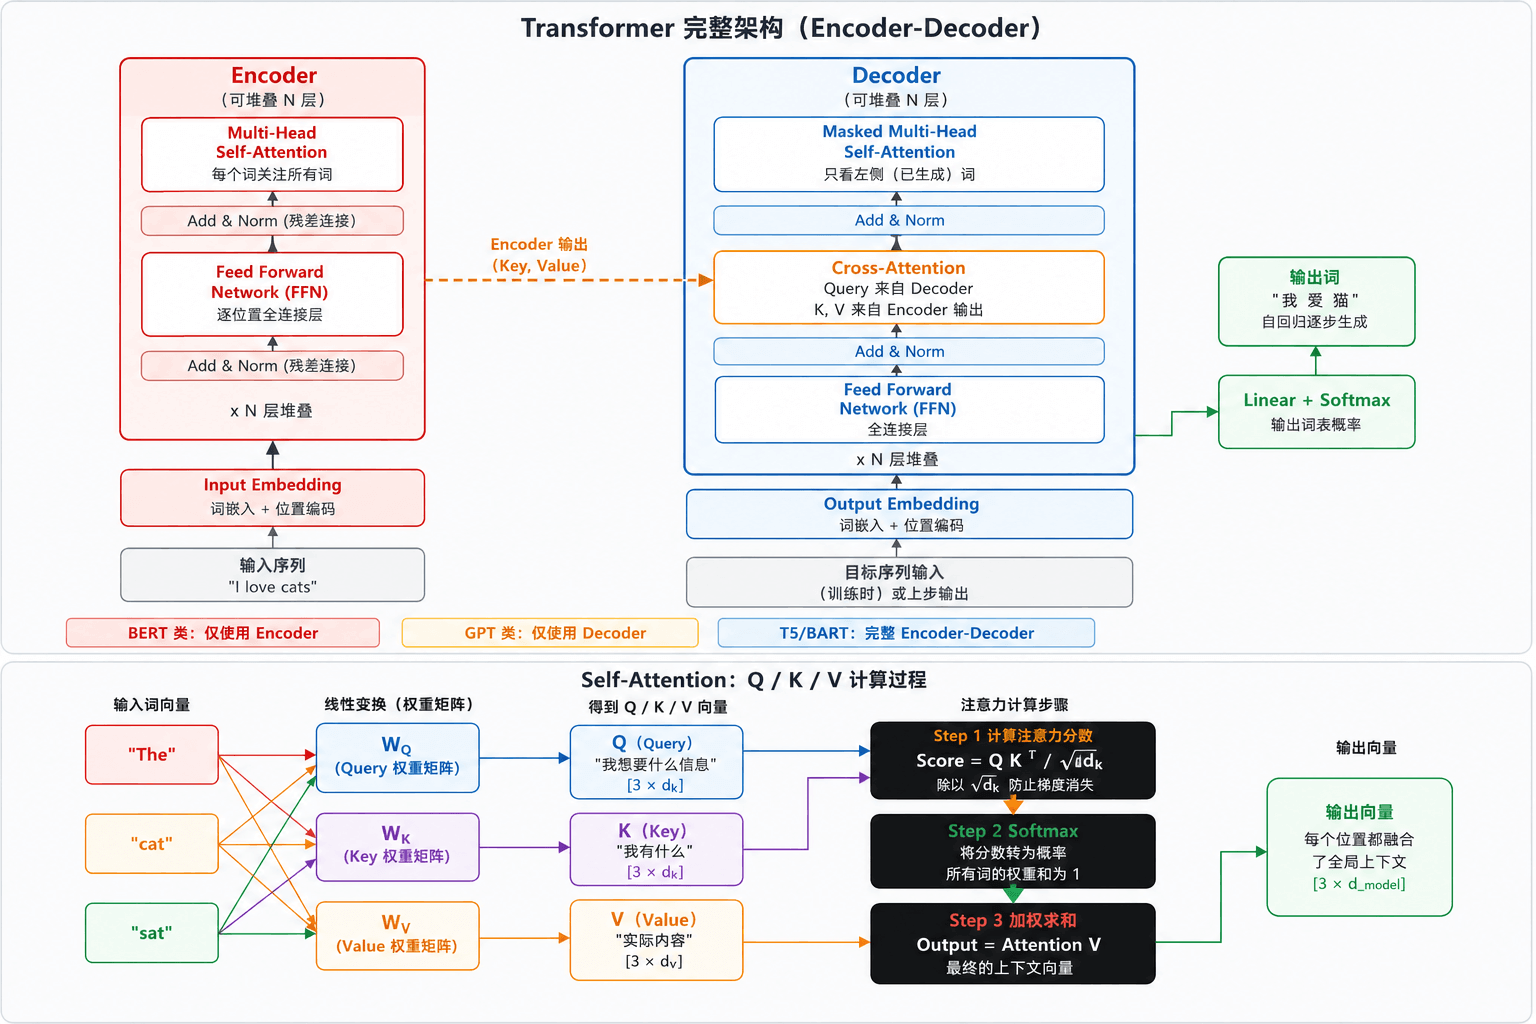
三大模型家族
三大模型家族:架构 x 适用场景 x 代表模型 仅 Encoder 模型 双向注意力,理解全局上下文 适合:分类、NER、问答(理解类) 代表:BERT、RoBERTa、ALBERT 中文:BERT-wwm、MacBERT 特点:可同时看到全部输入 输入 -> [CLS] 表示全局,[MASK] 做预训练 仅 Decoder 模型 因果注意力(只看左侧),自回归生成 适合:文本生成、对话、代码生成 代表:GPT 系列、LLaMA、Qwen 中文:ChatGLM、Baichuan 特点:逐词预测下一个词 输入 -> 预测下一词 -> 拼接再预测 -> 循环 Encoder-Decoder 模型 序列到序列(Seq2Seq)任务 适合:翻译、摘要、问答生成 代表:T5、BART、mT5 中文:mT5、PEGASUS-Chinese 特点:编码输入,解码生成输出 源序列 -> Encoder -> Decoder -> 目标序列
安装与环境配置
安装
# 基础安装
pip install transformers

# 完整安装(包含训练依赖)
pip install transformers[torch]       # PyTorch 后端(推荐)
pip install transformers[tf-cpu]      # TensorFlow 后端
pip install transformers[flax]        # JAX/Flax 后端

# 常用配套库
pip install datasets          # HuggingFace 数据集库
pip install evaluate          # 模型评估指标
pip install accelerate        # 多GPU/混合精度训练
pip install peft              # 参数高效微调(LoRA等)
pip install tokenizers        # 高性能分词器
pip install sentencepiece     # 部分模型(T5/LLaMA)需要

# 验证安装
python -c "import transformers; print(transformers.__version__)"
环境变量配置
# 设置模型缓存目录(模型下载后缓存到此路径,默认 ~/.cache/huggingface)
export HF_HOME=/data/huggingface_cache

# 国内用户:使用镜像站加速下载(推荐 hf-mirror.com)
export HF_ENDPOINT=https://hf-mirror.com

# 离线模式(网络不可用时,只使用已缓存的模型)
export TRANSFORMERS_OFFLINE=1

# 禁用进度条(CI/CD 环境)
export DISABLE_TQDM=1
实例
# 也可以在代码中设置

import os

os.environ["HF_ENDPOINT"] = "https://hf-mirror.com"

# 查看当前缓存目录

from transformers.utils import TRANSFORMERS_CACHE

print(TRANSFORMERS_CACHE)
Pipeline:五行代码跑 AI
Pipeline 是 Transformers 最高级别的抽象,把模型加载、预处理、推理、后处理全部封装好,三到五行代码即可完成推理。
Pipeline 内部工作流程 原始输入 文本 / 图像 音频 / 等数据 预处理 Tokenizer 分词 转为 token IDs Padding/Truncation 模型推理 前向传播 输出 logits 或隐藏层向量 后处理 Softmax/Argmax 解码 token->文字 格式化输出 结果 标签/分数 生成文本 Pipeline 自动完成全部步骤,用户只需传入原始输入,拿到格式化结果
Pipeline 快速示例大全
实例
from transformers import pipeline

# 1. 情感分析(文本分类)

classifier = pipeline("sentiment-analysis")

result = classifier("I love using Hugging Face Transformers!")

# -> [{'label': 'POSITIVE', 'score': 0.9998}]

# 2. 文本生成

generator = pipeline("text-generation", model="gpt2")

result = generator("Once upon a time in a land far away,",

    max_new_tokens=50, num_return_sequences=1, temperature=0.8)

# 3. 填空(掩码语言模型)

unmasker = pipeline("fill-mask", model="bert-base-uncased")

result = unmasker("The capital of France is [MASK].")

# -> [{'token_str': 'paris', 'score': 0.9823}, ...]

# 4. 命名实体识别(NER)

ner = pipeline("ner", aggregation_strategy="simple")

result = ner("My name is John and I work at Google in New York.")

# -> [{'entity_group': 'PER', 'word': 'John', 'score': 0.998}, ...]

# 5. 抽取式问答

qa = pipeline("question-answering")

result = qa(question="Who invented Python?",

    context="Python was created by Guido van Rossum in 1991.")

# -> {'answer': 'Guido van Rossum', 'score': 0.9887}

# 6. 文本摘要

summarizer = pipeline("summarization", model="facebook/bart-large-cnn")

result = summarizer(article, max_length=60, min_length=20)

# 7. 机器翻译

translator = pipeline("translation", model="Helsinki-NLP/opus-mt-en-zh")

result = translator("Hello, how are you today?")

# -> [{'translation_text': '你好,你今天怎么样?'}]

# 8. 零样本分类(不需要专门训练)

zero_shot = pipeline("zero-shot-classification")

result = zero_shot("I love playing football",

    candidate_labels=["sports", "politics", "technology"])

# -> {'labels': ['sports', ...], 'scores': [0.972, ...]}
Pipeline 进阶配置
实例
import torch

from transformers import pipeline

# 指定 GPU

pipe = pipeline("text-generation", model="gpt2", device=0)

# 指定精度(省显存)

pipe = pipeline("text-generation", model="meta-llama/Llama-2-7b-hf",

    torch_dtype=torch.float16, device_map="auto")

# 批量处理(提升吞吐量)

pipe = pipeline("sentiment-analysis", batch_size=32)

results = pipe(large_text_list)    # 自动分批推理

# 大文本分块处理

asr = pipeline("automatic-speech-recognition",

    model="openai/whisper-large-v2",

    chunk_length_s=30, stride_length_s=5)

result = asr("long_audio.wav", return_timestamps=True)
Tokenizer 深度解析
Tokenizer 是 NLP 的第一步:把原始文本转换成模型能理解的数字序列。
Tokenization 完整流程
Tokenization 完整过程:文本 -> 模型输入 Step 1 原始文本: "Hello, I'm learning Transformers! It's great." Step 2 分词(Tokenize): ["Hello", ",", "I", "'m", "learning", "Transform", "##ers", "!", ...] WordPiece/BPE 子词分词:罕见词被拆分(Transformers -> Transform + ##ers) Step 3 添加特殊标记: ["[CLS]", "Hello", ",", "I", "'m", "learning", "Transform", "##ers", ... "[SEP]"] [CLS]分类标记 [SEP]分隔符 [PAD]填充;不同模型特殊标记不同 Step 4 转换为 Token IDs: [101, 7592, 1010, 1045, 1005, 1049, 4083, 19081, 2121, ... 102] 每个 token 映射到词表中的整数索引,送入模型 Embedding 层
Tokenizer 核心用法
实例
from transformers import AutoTokenizer

# 加载 Tokenizer

tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")

# 一步完成编码

encoding = tokenizer(

    "Hello, I'm learning Transformers!",

    return_tensors="pt",        # 返回 PyTorch tensor

    padding=True,               # 填充到最长序列

    truncation=True,            # 超出长度时截断

    max_length=128,             # 最大长度

)

print(encoding.keys())

# -> dict_keys(['input_ids', 'token_type_ids', 'attention_mask'])

print(encoding["input_ids"][0][:8])

# -> tensor([101, 7592, 1010, 1045, 1005, 1049, 4083, 19081])

print(encoding["attention_mask"][0][:8])

# -> tensor([1, 1, 1, 1, 1, 1, 1, 1])    # 1=真实token, 0=填充

# 解码(ID -> 文本)

decoded = tokenizer.decode(encoding["input_ids"][0], skip_special_tokens=True)

print(decoded)   # -> "hello, i'm learning transformers!"

# 批量编码(自动 padding 对齐)

texts = ["Short.", "This is a much longer sentence for testing."]

batch = tokenizer(texts, padding=True, truncation=True, return_tensors="pt")

print(batch["input_ids"].shape)   # -> torch.Size([2, 10])

# 词表信息

print(f"词表大小: {tokenizer.vocab_size}")      # -> 30522

print(f"[CLS] ID: {tokenizer.cls_token_id}")     # -> 101

print(f"[SEP] ID: {tokenizer.sep_token_id}")     # -> 102

print(f"最大长度: {tokenizer.model_max_length}")  # -> 512
常见 Tokenizer 类型对比
三种主流分词算法对比 算法 原理 示例分词 代表模型 BPE Byte Pair Encoding 统计高频字符对合并 学习最优子词词表 "transformers" -> ["transform", "ers"] GPT / RoBERTa WordPiece 最大化语言模型概率 ## 前缀标记子词 "transformers" -> ["transform", "##ers"] BERT / DistilBERT SentencePiece Unigram / BPE 变体 语言无关,直接处理 原始字节,开头标记词首 "transformers" -> ["_transform", "ers"] T5 / LLaMA / Qwen
模型加载与推理
AutoClass:自动选择正确的模型类
AutoClass 工作原理:自动匹配正确的模型架构 模型名称 "bert-base-uncased" 或本地路径 AutoClass 读取 config.json 匹配架构类型 AutoModel / AutoTokenizer / ... 自动返回正确的类 BertForSequenceClassification GPT2LMHeadModel T5ForConditionalGeneration ... 常用 AutoClass 速查: AutoTokenizer 自动分词器 AutoModel 基础模型(输出隐藏层) AutoModelForSeqClass 文本分类任务 AutoModelForCausalLM 文本生成任务
实例
import torch

from transformers import AutoTokenizer, AutoModelForSequenceClassification

model_name = "bert-base-uncased"

tokenizer = AutoTokenizer.from_pretrained(model_name)

model = AutoModelForSequenceClassification.from_pretrained(

    model_name, num_labels=2, torch_dtype=torch.float16, device_map="auto"

)

# 手动推理完整流程

text = "Transformers is an amazing library!"

# 1. 编码

inputs = tokenizer(text, return_tensors="pt", truncation=True, max_length=512)

inputs = {k: v.to(model.device) for k, v in inputs.items()}

# 2. 前向传播

with torch.no_grad():

    outputs = model(**inputs)

# 3. 解析输出

logits = outputs.logits                       # shape: [1, 2]

probs  = torch.softmax(logits, dim=-1)

pred   = torch.argmax(probs, dim=-1).item()

id2label = model.config.id2label              # {0: 'LABEL_0', 1: 'LABEL_1'}

print(f"预测类别: {id2label[pred]}, 置信度: {probs[0][pred]:.4f}")
提取句子向量
实例
from transformers import AutoModel, AutoTokenizer

import torch

model = AutoModel.from_pretrained("bert-base-uncased")

tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")

def get_sentence_embedding(text: str) -> torch.Tensor:

    inputs = tokenizer(text, return_tensors="pt", max_length=512, truncation=True)

    with torch.no_grad():

        outputs = model(**inputs)

    # 对所有 token 做均值池化(Mean Pooling)

    token_embeddings = outputs.last_hidden_state          # [1, seq_len, 768]

    attention_mask = inputs["attention_mask"].unsqueeze(-1)

    mean_embedding = (token_embeddings * attention_mask).sum(1) / attention_mask.sum(1)

    return mean_embedding  # [1, 768]

vec = get_sentence_embedding("Hello world")

print(vec.shape)  # -> torch.Size([1, 768])
十大常见任务实战
文本分类(情感分析)
实例
from transformers import AutoTokenizer, AutoModelForSequenceClassification

import torch

model_name = "cardiffnlp/twitter-roberta-base-sentiment-latest"

tokenizer = AutoTokenizer.from_pretrained(model_name)

model = AutoModelForSequenceClassification.from_pretrained(model_name)

def predict_sentiment(texts):

    inputs = tokenizer(texts, return_tensors="pt", padding=True,

                       truncation=True, max_length=512)

    with torch.no_grad():

        logits = model(**inputs).logits

    probs = torch.softmax(logits, dim=-1)

    results = []

    for i, t in enumerate(texts):

        pid = probs[i].argmax().item()

        results.append({"text": t, "label": model.config.id2label[pid],

                         "score": round(probs[i][pid].item(), 4)})

    return results

print(predict_sentiment(["I love this!", "This is terrible."]))

# -> [{'text': 'I love this!', 'label': 'positive', 'score': 0.9756}, ...]
文本生成(对话 / 续写)
实例
from transformers import AutoTokenizer, AutoModelForCausalLM

import torch

model_name = "Qwen/Qwen2-1.5B-Instruct"     # 阿里通义千问(支持中文)

tokenizer = AutoTokenizer.from_pretrained(model_name)

model = AutoModelForCausalLM.from_pretrained(

    model_name, torch_dtype=torch.float16, device_map="auto"

)

messages = [

    {"role": "system", "content": "你是一个有用的 AI 助手。"},

    {"role": "user", "content": "请用三句话解释什么是 Transformer?"},

]

text = tokenizer.apply_chat_template(messages, tokenize=False,

                                      add_generation_prompt=True)

inputs = tokenizer(text, return_tensors="pt").to(model.device)

with torch.no_grad():

    output_ids = model.generate(

        **inputs, max_new_tokens=300, temperature=0.7, top_p=0.9,

        do_sample=True, repetition_penalty=1.1,

        pad_token_id=tokenizer.eos_token_id,

    )

new_tokens = output_ids[0][inputs["input_ids"].shape[1]:]

response = tokenizer.decode(new_tokens, skip_special_tokens=True)

print(response)
命名实体识别(NER)
实例
from transformers import pipeline

ner = pipeline("ner", model="dslim/bert-base-NER", aggregation_strategy="simple")

result = ner("Elon Musk founded SpaceX in 2002 and Tesla Motors in 2003.")

for entity in result:

    print(f"{entity['word']:<20} -> {entity['entity_group']} ({entity['score']:.3f})")

# 中文 NER

ner_cn = pipeline("ner", model="hfl/chinese-bert-wwm-ext-ner-msra",

                   aggregation_strategy="simple")

result = ner_cn("小明在北京大学读书,后来去了阿里巴巴工作。")
机器翻译
实例
from transformers import pipeline

# 英译中

translator = pipeline("translation", model="Helsinki-NLP/opus-mt-en-zh")

result = translator("Artificial intelligence is transforming the world.")

print(result[0]["translation_text"])   # -> 人工智能正在改变世界。

# 中译英

translator_zh = pipeline("translation", model="Helsinki-NLP/opus-mt-zh-en")

result = translator_zh("人工智能正在改变世界。")

print(result[0]["translation_text"])
文本摘要
实例
from transformers import pipeline

summarizer = pipeline("summarization", model="facebook/bart-large-cnn")

result = summarizer(long_text, max_length=80, min_length=30,

                     do_sample=False, no_repeat_ngram_size=3)

print(result[0]["summary_text"])
微调(Fine-tuning)
微调是将预训练模型适配到你的特定任务和数据上,是 Transformers 最重要的应用场景。
微调流程全景
Transformers 微调完整流程 准备数据 数据集加载 HF datasets or 自定义 CSV Tokenize 编码 Padding 对齐 DataLoader 关键:数据质量 > 数据数量 加载模型 AutoModelForTask 指定 num_labels 冻结底层参数 (可选) 只微调顶层 技巧:小数据集 先冻结底层 训练配置 TrainingArguments 学习率:2e-5 Batch:32 Epochs:3~5 Warmup 步数 权重衰减 技巧:学习率 最重要 训练 & 评估 Trainer.train() 监控 loss 曲线 验证集评估 Early stopping 保存最优 ckpt 注意:过拟合 对比基线 保存 save_model() save_pretrained 推送 Hub 生产部署 量化推理 ONNX 导出 使用 HuggingFace Trainer 可以大幅简化训练流程,自动处理梯度累积、混合精度、分布式训练等
完整微调示例:文本分类
实例
from datasets import load_dataset

from transformers import (

    AutoTokenizer, AutoModelForSequenceClassification,

    TrainingArguments, Trainer, DataCollatorWithPadding,

    EarlyStoppingCallback,

)

import evaluate, numpy as np

# 1. 加载数据集

dataset = load_dataset("imdb")   # HF Hub 公开数据集

# 2. Tokenizer + 预处理

MODEL_NAME = "bert-base-uncased"

tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)

def tokenize_fn(examples):

    return tokenizer(examples["text"], truncation=True, max_length=512)

tokenized_ds = dataset.map(tokenize_fn, batched=True,

                           remove_columns=["text"])

tokenized_ds = tokenized_ds.rename_column("label", "labels")

tokenized_ds.set_format("torch")

data_collator = DataCollatorWithPadding(tokenizer=tokenizer)

# 3. 加载模型

model = AutoModelForSequenceClassification.from_pretrained(

    MODEL_NAME, num_labels=2,

    id2label={0: "NEGATIVE", 1: "POSITIVE"},

    label2id={"NEGATIVE": 0, "POSITIVE": 1},

)

# 4. 评估指标

accuracy = evaluate.load("accuracy")

f1 = evaluate.load("f1")

def compute_metrics(eval_pred):

    logits, labels = eval_pred

    preds = np.argmax(logits, axis=-1)

    return {"accuracy": accuracy.compute(predictions=preds, references=labels)["accuracy"],

            "f1": f1.compute(predictions=preds, references=labels, average="binary")["f1"]}

# 5. 训练参数

training_args = TrainingArguments(

    output_dir="./results", num_train_epochs=3,

    per_device_train_batch_size=16, per_device_eval_batch_size=32,

    gradient_accumulation_steps=2, learning_rate=2e-5,

    weight_decay=0.01, warmup_ratio=0.1,

    evaluation_strategy="steps", eval_steps=500,

    save_strategy="steps", save_steps=500,

    load_best_model_at_end=True, metric_for_best_model="f1",

    fp16=True, logging_steps=100, seed=42,

)

# 6. 创建 Trainer 并训练

trainer = Trainer(

    model=model, args=training_args,

    train_dataset=tokenized_ds["train"],

    eval_dataset=tokenized_ds["test"],

    tokenizer=tokenizer, data_collator=data_collator,

    compute_metrics=compute_metrics,

    callbacks=[EarlyStoppingCallback(early_stopping_patience=3)],

)

trainer.train()

# 7. 评估并保存

eval_result = trainer.evaluate()

print(f"准确率: {eval_result['eval_accuracy']:.4f}")

print(f"F1: {eval_result['eval_f1']:.4f}")

trainer.save_model("./my-sentiment-model")

tokenizer.save_pretrained("./my-sentiment-model")
LoRA 参数高效微调(推荐)
LoRA 原理:只训练低秩矩阵,冻结原始权重 全量微调(Full Fine-tuning) W + ΔW 更新全部权重矩阵 参数量:全部(如 7B 参数全训) 显存需求:极高(需 4x 模型大小) 成本:昂贵,需要大量 GPU LoRA 微调 W(冻结) 不参与训练 + B x A r << d(低秩矩阵) 只训练这里 参数量:原来的 0.1%~1% 显存需求:低(只存低秩矩阵梯度) 成本:单卡 24GB 可微调 7B LoRA 将 ΔW 分解为两个低秩矩阵,r 远小于 d(通常 r=8~64),大幅降低训练成本
实例
from peft import LoraConfig, get_peft_model, TaskType

from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments

import torch

model_name = "meta-llama/Llama-2-7b-hf"

model = AutoModelForCausalLM.from_pretrained(

    model_name, torch_dtype=torch.float16, device_map="auto",

    load_in_4bit=True,        # 4-bit 量化加载(QLoRA),进一步省显存

)

# 配置 LoRA

lora_config = LoraConfig(

    task_type=TaskType.CAUSAL_LM, r=16, lora_alpha=32,

    lora_dropout=0.05,

    target_modules=["q_proj", "v_proj", "k_proj", "o_proj"],

)

model = get_peft_model(model, lora_config)

model.print_trainable_parameters()

# -> trainable: 4,194,304 || all: 6,742,609,920 || 0.0622%
LoRA 优势:只训练不到 1% 的参数,显存降低 60-70%,速度快 2-3 倍,权重文件仅几 MB,可为同一基础模型保存多个 LoRA 适配器用于不同任务。
模型保存、加载与发布
实例
# 本地保存

model.save_pretrained("./my-model")

tokenizer.save_pretrained("./my-model")

# 本地加载

model = AutoModelForSequenceClassification.from_pretrained("./my-model")

tokenizer = AutoTokenizer.from_pretrained("./my-model")

# 发布到 HuggingFace Hub

from huggingface_hub import login

login(token="your_hf_token")   # huggingface.co/settings/tokens

model.push_to_hub("your-username/my-sentiment-model")

tokenizer.push_to_hub("your-username/my-sentiment-model")

# 通过 Trainer 直接发布

training_args = TrainingArguments(

    output_dir="your-username/my-model",

    push_to_hub=True, hub_strategy="every_save",

)
性能优化技巧
推理加速全景
推理加速技术栈:从简单到深度优化 Level 1 - 零成本优化 torch.no_grad() 推理 | fp16/bf16 半精度 | batch 推理 | device_map="auto" 自动分配设备 加速:1.5~2x Level 2 - 量化(模型压缩) bitsandbytes 4-bit/8-bit 量化 | GPTQ(后训练量化)| AWQ(激活感知量化) 加速:2~4x,显存减半 Level 3 - 编译与运行时优化 torch.compile()(PyTorch 2.0)| FlashAttention-2 | xFormers | Optimum(TensorRT/ONNX) 加速:3~10x Level 4 - 专用推理引擎 vLLM(LLM 高吞吐推理)| TGI | TensorRT-LLM | llama.cpp(CPU) 生产级,最高性能
实例
# 4-bit 量化加载(13B 模型只需约 7GB 显存)

from transformers import BitsAndBytesConfig, AutoModelForCausalLM

import torch

quant_config = BitsAndBytesConfig(

    load_in_4bit=True, bnb_4bit_compute_dtype=torch.float16,

    bnb_4bit_use_double_quant=True, bnb_4bit_quant_type="nf4",

)

model = AutoModelForCausalLM.from_pretrained(

    "meta-llama/Llama-2-13b-hf",

    quantization_config=quant_config, device_map="auto",

)

# FlashAttention-2 加速(需 pip install flash-attn)

model = AutoModelForCausalLM.from_pretrained(

    "mistralai/Mistral-7B-v0.1",

    attn_implementation="flash_attention_2",

    torch_dtype=torch.bfloat16, device_map="auto",

)

# torch.compile (PyTorch 2.0+)

model = torch.compile(model, mode="reduce-overhead")
常见问题排查
常见报错与解决方案速查 错误信息 原因与解决方案 CUDA out of memory 显存不足 减小 batch_size;加 gradient_accumulation_steps;用 fp16/4-bit;用更小模型 OSError: model not found 模型名称错误或网络问题 检查拼写;设置 HF_ENDPOINT 镜像;已下载则用本地路径 ValueError: num_labels mismatch 加载模型时显式指定 num_labels=你的类别数 tensors on different devices inputs = {k: v.to(model.device) for k, v in inputs.items()} loss = NaN / loss 不下降 检查学习率(太大会 NaN);检查 labels 值域(0~N-1);加 gradient_clipping slow tokenizer / 速度慢 pip install tokenizers 安装 Rust 快速版本;使用 use_fast=True(默认)
总结与学习路径
Transformers 学习路径与核心知识点 第一阶段 入门(1周) pip install 配置环境 Pipeline 跑通 5 个任务 理解 Tokenizer 流程 AutoModel 手动推理 理解 Encoder/Decoder 读懂模型输出结构 第二阶段 进阶(2周) 加载 Hub 上的模型 文本分类微调实战 Trainer API 熟练使用 自定义数据集处理 compute_metrics 评估 保存发布到 Hub 第三阶段 高级(3周) LoRA / PEFT 微调 量化(4-bit/8-bit) 多模态模型使用 自定义训练循环 Accelerate 多 GPU FlashAttention 加速 第四阶段 专家(持续) 自定义模型架构 预训练从头开始 vLLM 生产部署 RLHF/DPO 对齐 贡献开源模型 研究前沿论文 每个阶段都应动手实践:找一个真实数据集,跑通训练->评估->发布的完整流程
关键 API 速查
实例
# 1. 加载分词器

tokenizer = AutoTokenizer.from_pretrained("model_name")

# 2. 编码文本

inputs = tokenizer(text, return_tensors="pt", truncation=True, max_length=512)

# 3. 加载模型

model = AutoModelForSequenceClassification.from_pretrained("model_name", num_labels=N)

# 4. 推理

with torch.no_grad():

    outputs = model(**inputs)

# 5. Pipeline

pipe = pipeline("task_name", model="model_name")

# 6. 训练配置

args = TrainingArguments(output_dir="./out", num_train_epochs=3, learning_rate=2e-5)

# 7. 训练

trainer = Trainer(model=model, args=args, train_dataset=ds, compute_metrics=fn)

# 8. 保存

model.save_pretrained("./my-model")

tokenizer.save_pretrained("./my-model")

# 9. 数据集

dataset = load_dataset("dataset_name")

dataset = dataset.map(tokenize_fn, batched=True)

# 10. LoRA

config = LoraConfig(r=16, lora_alpha=32, target_modules=["q_proj","v_proj"])

model = get_peft_model(model, config)
参考资源
- Transformers 官方文档
- Hugging Face NLP Course(免费课程)
- Hugging Face Hub 模型库(40万+)
- Hugging Face 数据集
- HF 国内镜像站
- Papers With Code(论文+代码)
AI 思考中...