TensorFlow 生产环境
TensorFlow 作为业界领先的机器学习框架,在从实验环境迁移到生产环境时需要考虑诸多因素。
本文将全面介绍 TensorFlow 在生产环境中的关键考虑点,帮助开发者构建稳定、高效的机器学习系统。
1. 模型优化
1.1 模型量化
实例
python
# 训练后量化示例

import tensorflow as tf

converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)

converter.optimizations = [tf.lite.Optimize.DEFAULT]

tflite_quant_model = converter.convert()- 8位整数量化:减少75%模型大小,提升3-4倍推理速度
- 16位浮点量化:GPU上性能提升,精度损失较小
- 动态范围量化:仅量化权重,推理时激活保持浮点
1.2 模型剪枝
实例
python
# 使用TensorFlow Model Optimization Toolkit进行剪枝

pruning_params = {

    'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(

        initial_sparsity=0.50,

        final_sparsity=0.90,

        begin_step=0,

        end_step=end_step)

}

model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(

original_model, **pruning_params)- 移除对输出影响小的神经元连接
- 典型可减少60%参数而不显著影响精度
- 需要微调以恢复部分精度损失
1.3 模型蒸馏
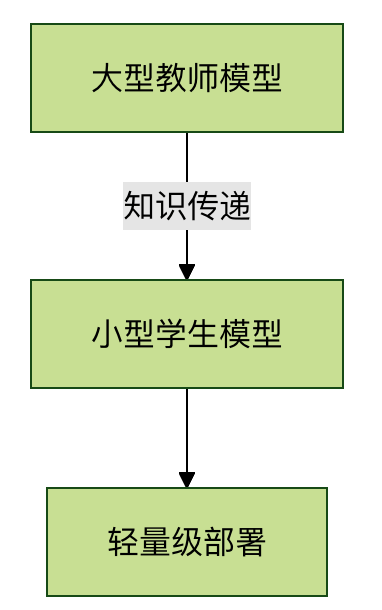
- 使用大型模型指导小型模型训练
- 保持 90% 以上精度同时减少 90% 参数量
- 特别适合边缘设备部署场景
2. 部署架构
2.1 服务模式对比
| 部署方式 | 延迟 | 吞吐量 | 资源使用 | 适用场景 |
|---|---|---|---|---|
| TensorFlow Serving | 中 | 高 | 中 | 云服务、高并发 |
| TFLite | 低 | 中 | 低 | 移动/IoT设备 |
| ONNX Runtime | 中 | 高 | 中 | 多框架统一部署 |
| 自定义gRPC服务 | 可调 | 可调 | 可调 | 特殊需求场景 |
2.2 微服务架构
实例
python
# 使用Flask构建的简单模型服务

from flask import Flask, request

import tensorflow as tf

app = Flask(__name__)

model = tf.keras.models.load_model('path/to/model')

@app.route('/predict', methods=['POST'])

def predict():

    data = request.json['data']

    prediction = model.predict(data)

return {'prediction': prediction.tolist()}- 容器化:推荐使用Docker打包模型和环境
- 服务发现:结合Kubernetes实现自动扩缩容
- 监控集成:Prometheus + Grafana监控体系
3. 性能优化
3.1 硬件加速
GPU优化技巧:
- 使用
tf.config.optimizer.set_jit(True)启用XLA编译 - 批量处理输入数据(典型批量大小32-256)
- 使用混合精度训练(
tf.keras.mixed_precision)
TPU配置:
实例
python
resolver = tf.distribute.cluster_resolver.TPUClusterResolver()

tf.config.experimental_connect_to_cluster(resolver)

tf.tpu.experimental.initialize_tpu_system(resolver)

strategy = tf.distribute.TPUStrategy(resolver)
3.2 图优化
实例
python
# 会话配置优化

config = tf.compat.v1.ConfigProto()

config.graph_options.optimizer_options.global_jit_level = tf.compat.v1.OptimizerOptions.ON_1

config.gpu_options.allow_growth = True

session = tf.compat.v1.Session(config=config)- 常量折叠
- 操作融合
- 死代码消除
- 内存优化
4. 监控与维护
4.1 关键监控指标
系统指标:
- GPU/CPU利用率
- 内存使用量
- 请求延迟(P50/P90/P99)
模型指标:
- 预测置信度分布
- 输入数据分布偏移
- 模型衰减指标
4.2 A/B测试框架
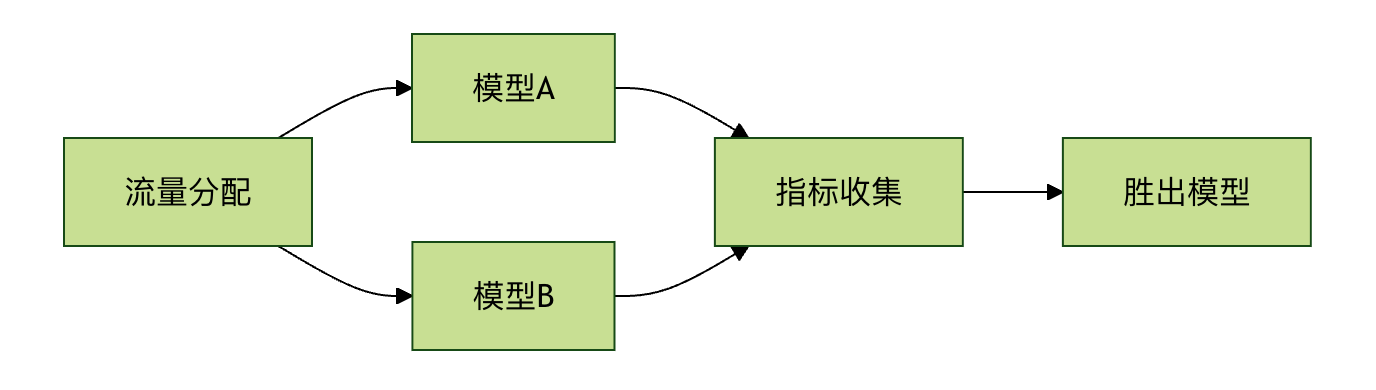
- 逐步流量切换(5% → 50% → 100%)
- 多维度指标对比(业务指标+技术指标)
- 自动回滚机制
5. 安全考虑
5.1 模型保护
- 使用
tf.saved_model.save加密模型 - 实现模型水印技术
- 定期轮换部署密钥
5.2 输入验证
实例
python
# 输入数据验证示例

def validate_input(input_data):

    if not isinstance(input_data, np.ndarray):

        raise ValueError("Input must be numpy array")

    if input_data.shape != EXPECTED_SHAPE:

        raise ValueError(f"Shape must be {EXPECTED_SHAPE}")

    if np.isnan(input_data).any():

raise ValueError("Input contains NaN values")- 数据类型检查
- 数值范围验证
- 异常输入过滤
6. 持续集成与交付
6.1 ML Pipeline设计
实例
python
# 使用TFX构建的简单pipeline

from tfx.components import Trainer

from tfx.proto import trainer_pb2

trainer = Trainer(

    module_file=module_file,

    transformed_examples=transform.outputs['transformed_examples'],

    schema=infer_schema.outputs['schema'],

    train_args=trainer_pb2.TrainArgs(num_steps=10000),

eval_args=trainer_pb2.EvalArgs(num_steps=5000))- 自动化模型训练
- 自动化模型评估
- 自动化模型部署
6.2 版本控制策略
- 模型版本与代码版本绑定
- 数据快照保存
- 完整的实验记录
AI 思考中...