TensorFlow 模型调优技巧
模型调优是机器学习工作流程中至关重要的环节,它直接影响模型的最终性能表现。在TensorFlow中,我们可以通过多种技术手段来提升模型的准确率和泛化能力。
为什么需要模型调优
- 初始模型通常不够理想:首次训练的模型往往存在欠拟合或过拟合问题
- 资源利用优化:通过调优可以在相同计算资源下获得更好性能
- 业务需求匹配:不同应用场景对模型有不同要求(如精度vs速度)
1.2 调优的主要方向
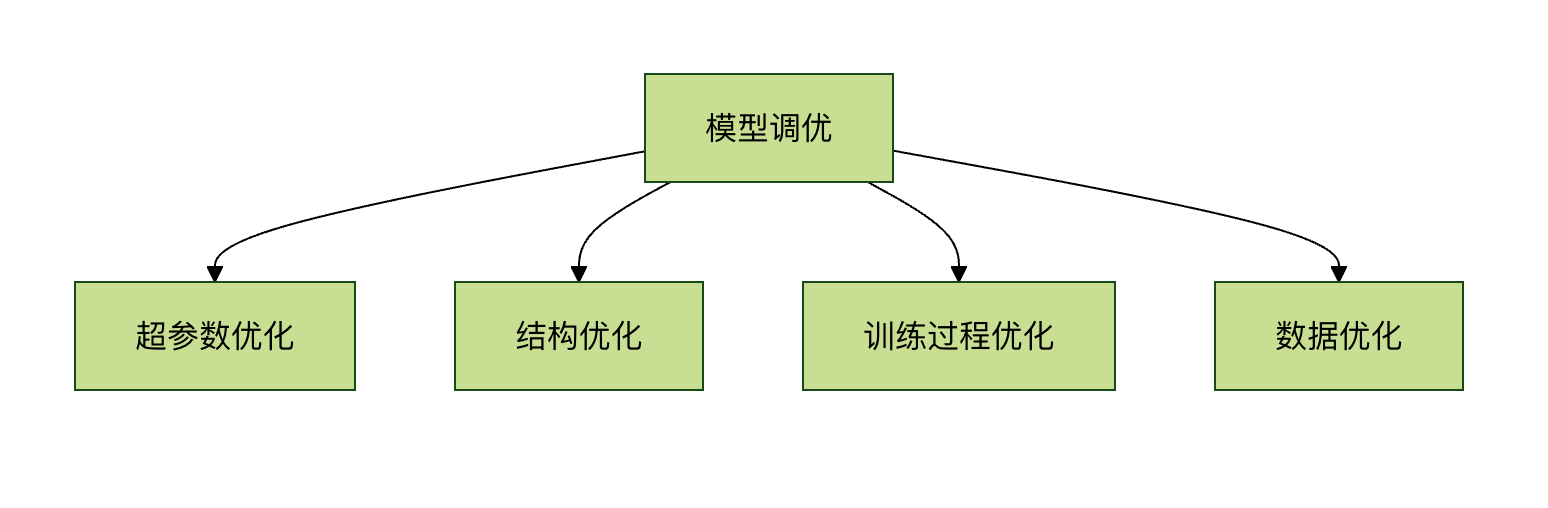
超参数调优技巧
学习率调整
学习率是最关键的超参数之一,直接影响模型收敛速度和最终性能。
静态学习率设置
实例
python
# 基本学习率设置示例

optimizer = tf.keras.optimizers.Adam(learning_rate=0.001)
动态学习率策略
实例
python
# 学习率衰减示例

initial_learning_rate = 0.1

lr_schedule = tf.keras.optimizers.schedules.ExponentialDecay(

    initial_learning_rate,

    decay_steps=10000,

    decay_rate=0.96,

    staircase=True)

optimizer = tf.keras.optimizers.SGD(learning_rate=lr_schedule)
学习率查找器
实例
python
# 使用Keras Tuner进行学习率搜索

import keras_tuner as kt

def build_model(hp):

    model = tf.keras.Sequential()

    model.add(tf.keras.layers.Dense(10))

    # 设置学习率搜索范围

    hp_learning_rate = hp.Choice('learning_rate', values=[1e-2, 1e-3, 1e-4])

    model.compile(optimizer=tf.keras.optimizers.Adam(learning_rate=hp_learning_rate),

                  loss='mse')

    return model

tuner = kt.RandomSearch(build_model, objective='val_loss', max_trials=5)
批量大小选择
批量大小影响训练稳定性和内存使用:
| 批量大小 | 优点 | 缺点 |
|---|---|---|
| 小批量(16-64) | 收敛快,泛化好 | 训练不稳定 |
| 中批量(64-256) | 平衡选择 | 需要更多内存 |
| 大批量(256+) | 训练稳定 | 可能陷入局部最优 |
模型结构优化
层大小与深度调整
宽度调整技巧
实例
python
# 使用Keras Tuner自动搜索最佳层大小

def build_model(hp):

    model = tf.keras.Sequential()

    # 搜索最佳神经元数量

    hp_units = hp.Int('units', min_value=32, max_value=512, step=32)

    model.add(tf.keras.layers.Dense(units=hp_units, activation='relu'))

    model.add(tf.keras.layers.Dense(10))

    model.compile(optimizer='adam', loss='mse')

    return model
深度调整策略
1、从浅层网络开始,逐步增加深度
2、使用残差连接(ResNet)解决深度网络梯度消失问题
实例
python
# 残差块示例

def residual_block(x, filters):

  shortcut = x

  x = tf.keras.layers.Conv2D(filters, (3,3), padding='same')(x)

  x = tf.keras.layers.BatchNormalization()(x)

  x = tf.keras.layers.Activation('relu')(x)

  x = tf.keras.layers.Conv2D(filters, (3,3), padding='same')(x)

  x = tf.keras.layers.BatchNormalization()(x)

  x = tf.keras.layers.Add()([shortcut, x])

  return tf.keras.layers.Activation('relu')(x)
正则化技术
Dropout
实例
python
model = tf.keras.Sequential([

    tf.keras.layers.Dense(128, activation='relu'),

    tf.keras.layers.Dropout(0.5),  # 50%的神经元会被随机丢弃

    tf.keras.layers.Dense(10)

])
L1/L2正则化
实例
python
# 添加L2正则化

tf.keras.layers.Dense(64,

                     activation='relu',

                     kernel_regularizer=tf.keras.regularizers.l2(0.01))
早停法(Early Stopping)
实例
python
early_stopping = tf.keras.callbacks.EarlyStopping(

    monitor='val_loss',

    patience=5,  # 连续5个epoch验证损失没有改善则停止

    restore_best_weights=True)  # 恢复最佳权重

model.fit(x_train, y_train,

          validation_data=(x_val, y_val),

          epochs=100,

          callbacks=[early_stopping])
训练过程优化
数据增强
实例
python
# 图像数据增强示例

data_augmentation = tf.keras.Sequential([

    tf.keras.layers.RandomFlip("horizontal"),

    tf.keras.layers.RandomRotation(0.1),

    tf.keras.layers.RandomZoom(0.1),

])

# 使用增强数据训练

model.fit(data_augmentation(x_train), y_train, epochs=10)
批归一化(Batch Normalization)
实例
python
model = tf.keras.Sequential([

    tf.keras.layers.Dense(64),

    tf.keras.layers.BatchNormalization(),

    tf.keras.layers.Activation('relu'),

    tf.keras.layers.Dense(10)

])
梯度裁剪
实例
python
# 梯度裁剪防止梯度爆炸

optimizer = tf.keras.optimizers.Adam(clipvalue=1.0)
高级调优技术
自动化超参数调优
实例
python
# 使用Keras Tuner进行自动化调优

tuner = kt.Hyperband(

    build_model,

    objective='val_accuracy',

    max_epochs=10,

    factor=3,

    directory='my_dir',

    project_name='intro_to_kt')

tuner.search(x_train, y_train, epochs=10, validation_data=(x_val, y_val))

best_model = tuner.get_best_models(num_models=1)[0]
模型蒸馏
实例
python
# 教师模型训练

teacher = tf.keras.models.load_model('teacher_model.h5')

# 学生模型定义

student = tf.keras.Sequential([...])

# 蒸馏损失

def distillation_loss(y_true, y_pred, teacher_pred, temp=5.0):

    return tf.keras.losses.kl_divergence(

        tf.nn.softmax(teacher_pred/temp),

        tf.nn.softmax(y_pred/temp))
调优实践建议
- 建立基准:先训练一个简单模型作为基准
- 一次调整一个参数:避免同时改变多个参数
- 记录实验:使用TensorBoard或MLflow跟踪实验
- 验证集使用:确保验证集代表真实数据分布
- 考虑计算成本:平衡调优效果与资源消耗
实例
python
# 使用TensorBoard记录训练过程

tensorboard_callback = tf.keras.callbacks.TensorBoard(log_dir="./logs")

model.fit(x_train, y_train, epochs=10, callbacks=[tensorboard_callback])
通过系统性地应用这些调优技巧,你可以显著提升TensorFlow模型的性能表现。记住,模型调优是一个迭代过程,需要耐心和细致的实验设计。
AI 思考中...