TensorFlow tf.data API
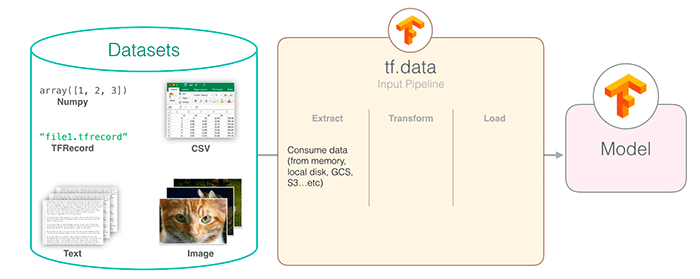
TensorFlow tf.data API 是 TensorFlow 提供的高效数据输入管道构建工具,专门用于处理大规模数据集。
tf.data API 解决了传统数据加载方式中的性能瓶颈问题,使数据预处理和模型训练能够并行进行。
为什么需要 tf.data API
- 性能优势:比传统方法快 10-100 倍
- 内存效率:支持流式处理超大数据集
- 灵活性:可组合的数据转换操作
- 易用性:简洁的链式调用接口
核心概念
Dataset 对象
Dataset 是 tf.data API 的核心抽象,表示一系列元素,其中每个元素包含一个或多个张量。
创建 Dataset 的三种主要方式
1、从内存数据创建
实例
python
dataset = tf.data.Dataset.from_tensor_slices([1, 2, 3, 4, 5])2、从文件创建
实例
python
dataset = tf.data.TextLineDataset(["file1.txt", "file2.txt"])3、从生成器创建
实例
python
def gen():

    for i in range(10):

        yield i


dataset = tf.data.Dataset.from_generator(gen, output_types=tf.int32)
数据转换操作
| 操作类型 | 常用方法 | 说明 |
|---|---|---|
| 单元素转换 | map, filter | 对每个元素单独处理 |
| 多元素转换 | batch, window | 涉及多个元素的操作 |
| 全局转换 | shuffle, repeat | 影响整个数据集的行为 |
关键操作详解
1. map 操作
map 是最常用的转换操作,用于对每个元素应用自定义函数。
实例
python
# 对每个数字进行平方

dataset = dataset.map(lambda x: x**2)

# 处理图像数据的典型用法

def process_image(image_path):

    img = tf.io.read_file(image_path)

    img = tf.image.decode_jpeg(img, channels=3)

    img = tf.image.resize(img, [256, 256])

    return img

image_dataset = image_dataset.map(process_image)最佳实践:
- 使用
num_parallel_calls参数启用并行处理 - 对于 CPU 密集型操作,设置
tf.data.experimental.AUTOTUNE
2. batch 操作
将多个元素组合成一个批次。
实例
python
# 创建32大小的批次

batched_dataset = dataset.batch(32)

# 不等长序列的填充批次

padded_batch = dataset.padded_batch(

    32,

    padded_shapes=([None], []),

    padding_values=(0.0, 0)

)
3. shuffle 操作
打乱数据顺序,对训练至关重要。
实例
python
# 基本用法

shuffled = dataset.shuffle(buffer_size=10000)

# 最佳实践:buffer_size应 >= 数据集大小

full_shuffle = dataset.shuffle(buffer_size=len(dataset))
性能优化技巧
预取 (Prefetch)
让数据加载和模型执行重叠进行:
实例
python
dataset = dataset.prefetch(buffer_size=tf.data.experimental.AUTOTUNE)并行化处理
实例
python
dataset = dataset.map(

    process_func,

    num_parallel_calls=tf.data.experimental.AUTOTUNE

)
缓存机制
实例
python
# 内存缓存

dataset = dataset.cache()

# 文件缓存

dataset = dataset.cache(filename='/tmp/cache')
完整示例
图像分类数据管道
实例
python
def build_image_pipeline(file_pattern, batch_size=32, is_training=True):

    dataset = tf.data.Dataset.list_files(file_pattern)


    if is_training:

        dataset = dataset.shuffle(10000)


    dataset = dataset.map(

        lambda x: load_and_preprocess_image(x),

        num_parallel_calls=tf.data.experimental.AUTOTUNE

    )


    dataset = dataset.batch(batch_size)


    if is_training:

        dataset = dataset.repeat()


    return dataset.prefetch(buffer_size=tf.data.experimental.AUTOTUNE)

def load_and_preprocess_image(path):

    image = tf.io.read_file(path)

    image = tf.image.decode_jpeg(image, channels=3)

    image = tf.image.resize(image, [224, 224])

    image = tf.cast(image, tf.float32) / 255.0  # 归一化

    return image
常见问题解答
Q1: 如何处理非常大的数据集?
解决方案:
- 使用
tf.data.Dataset.list_files创建文件数据集 - 使用交错读取 (
interleave) 并行处理多个文件 - 考虑使用 TFRecord 格式存储数据
Q2: 为什么我的数据管道速度很慢?
排查步骤:
- 检查是否使用了预取 (
prefetch) - 确保 map 操作设置了
num_parallel_calls - 验证 shuffle 的 buffer_size 是否足够大
- 考虑使用
tf.data.experimental.snapshot缓存中间结果
最佳实践总结
- 尽早 shuffle:在数据管道的早期应用 shuffle
- 延迟批处理:在应用 map 后再进行批处理
- 利用并行:尽可能使用并行化操作
- 重叠执行:使用 prefetch 实现数据加载和模型执行的重叠
- 合理缓存:对不变的数据进行缓存
通过遵循这些原则,您可以构建高效的数据输入管道,充分发挥 GPU 的计算能力,显著提升模型训练效率。
AI 思考中...