情感分析
情感分析(Sentiment Analysis)是自然语言处理(NLP)领域中最经典且应用最广泛的任务之一。它通过计算技术自动识别、提取和分析文本中的主观信息,判断作者对特定主题、产品或服务的态度是正面、负面还是中性。
情感分析的基本类型
按分析粒度分类
- 文档级情感分析:将整个文档作为一个整体判断情感倾向
- 句子级情感分析:分析单个句子的情感极性
- 方面级情感分析:针对文本中提到的特定方面进行情感判断
按情感维度分类
- 二分类:正面/负面
- 三分类:正面/中性/负面
- 多分类:更细粒度的情感分类(如愤怒、高兴、悲伤等)
- 情感强度分析:量化情感的强烈程度
基于词典的情感分析方法
基于词典的方法是最传统的情感分析技术,主要依赖预构建的情感词典。
核心组件
情感词典:包含带有情感极性和强度的词语集合
- 常用英文词典:SentiWordNet、AFINN、VADER
- 常用中文词典:知网Hownet情感词典、大连理工大学情感词汇本体库
强度调节器:处理程度副词和否定词的影响
- 程度副词:非常(1.5)、很(1.3)、有点(0.8)等
- 否定词:不、没有、绝非等
基本工作流程
实例
python
# 伪代码示例:基于词典的情感分析

def lexicon_based_sentiment(text):

    sentiment_score = 0

    words = tokenize(text)  # 分词

    for word in words:

        if word in positive_lexicon:

            sentiment_score += positive_lexicon[word]

        elif word in negative_lexicon:

            sentiment_score -= negative_lexicon[word]


    # 处理否定和程度修饰

    sentiment_score = apply_negation(words, sentiment_score)

    sentiment_score = apply_intensifier(words, sentiment_score)


    return normalize(sentiment_score)
优缺点分析
优点:
- 无需训练数据
- 计算效率高
- 可解释性强
缺点:
- 难以处理复杂语言现象(如讽刺、反语)
- 依赖词典的覆盖度和质量
- 无法捕捉上下文语义
基于机器学习的情感分析方法
机器学习方法通过从标注数据中学习模式来进行情感分析。
典型特征工程
- 词袋模型(BOW):文本表示为词语出现频率的向量
- TF-IDF:考虑词语在文档中的重要性
- N-gram特征:捕获局部词语序列模式
- 情感词典特征:结合词典方法的优势
常用算法
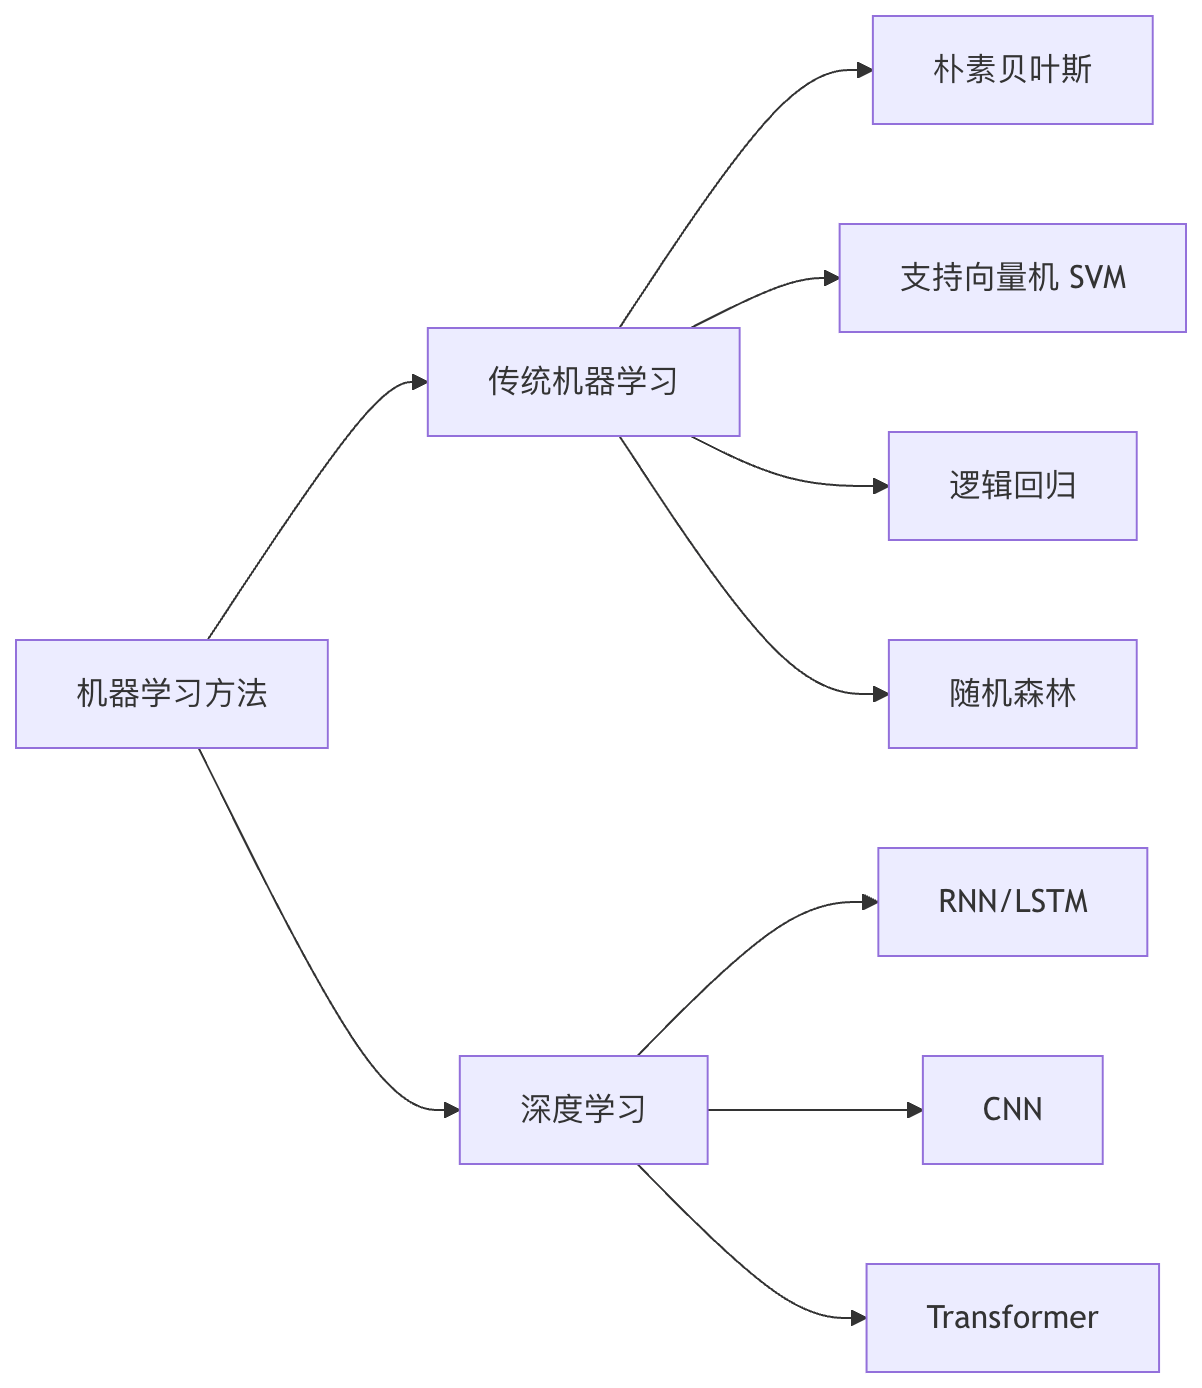
代码示例:使用Scikit-learn实现情感分类
实例
python
from sklearn.feature_extraction.text import TfidfVectorizer

from sklearn.svm import LinearSVC

from sklearn.pipeline import Pipeline

# 构建分类管道

sentiment_clf = Pipeline([

    ('tfidf', TfidfVectorizer(ngram_range=(1, 2))),

    ('clf', LinearSVC())

])

# 训练模型

sentiment_clf.fit(train_texts, train_labels)

# 预测新文本

prediction = sentiment_clf.predict(["这个产品非常好用,强烈推荐!"])

print(prediction)  # 输出: 'positive'
细粒度情感分析
细粒度情感分析(Aspect-Based Sentiment Analysis, ABSA)是更高级的情感分析任务,旨在识别文本中提到的特定方面及其对应的情感。
ABSA的核心子任务
方面提取:识别文本中讨论的实体或属性
- 显式方面:"手机的电池续航很好" → "电池"
- 隐式方面:"拍出来的照片很清晰" → "摄像头"
情感分类:对每个识别出的方面进行情感判断
实现方法对比
| 方法类型 | 代表模型 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|---|
| 流水线方法 | 先CRF提取方面,再分类器判断情感 | 资源有限场景 | 模块清晰,易于调试 | 误差传播 |
| 端到端方法 | BERT-ABSA、AOA-LSTM | 高精度要求 | 联合优化,性能更好 | 需要更多数据 |
| 多任务学习 | MT-DNN、Multi-Task BERT | 相关任务辅助 | 知识共享 | 任务平衡困难 |
代码示例:基于BERT的方面级情感分析
实例
python
from transformers import BertTokenizer, BertForSequenceClassification

import torch

# 加载预训练模型

model = BertForSequenceClassification.from_pretrained('bert-base-uncased', num_labels=3)

tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')

# 准备输入

text = "餐厅的环境很棒,但服务太慢了。"

aspect = "服务"

inputs = tokenizer(f"[CLS] {aspect} [SEP] {text} [SEP]", return_tensors="pt")

# 预测情感

outputs = model(**inputs)

predictions = torch.argmax(outputs.logits, dim=1)

print(predictions)  # 可能输出: 1 (负面)
情感分析的挑战与发展方向
当前主要挑战
- 上下文依赖性:同一词语在不同语境中可能有不同情感
- 领域适应性:在一个领域训练的模型在其他领域表现下降
- 多语言处理:不同语言的情感表达方式差异大
- 讽刺和反语检测:表面文字与实际情感相反的情况
前沿发展方向
- 多模态情感分析:结合文本、图像、语音等多种信息
- 跨语言情感分析:利用语言间的共性提高小语种表现
- 情感原因提取:不仅判断情感,还分析产生原因
- 个性化情感分析:考虑用户个人特点和历史行为
实践练习
练习1:构建基础情感分析器
- 使用NLTK的VADER词典实现一个简单的情感分析器
- 在电影评论数据集上测试其准确率
练习2:比较不同机器学习方法
- 分别使用朴素贝叶斯、SVM和逻辑回归训练情感分类器
- 使用交叉验证比较它们的性能差异
练习3:方面级情感分析实践
- 使用预训练的BERT模型在SemEval 2014餐厅评论数据集上进行微调
- 实现一个可以同时提取方面和判断情感的端到端系统
通过本文的学习,您应该已经掌握了情感分析的基本概念、主要方法和实现技术。情感分析作为NLP的基础任务,其技术不断发展,在实际应用中具有广泛的价值,从产品评论分析到社交媒体监控,都能发挥重要作用。
AI 思考中...