深度学习框架全面解析:从TensorFlow到模型部署
 Linux 命令大全
深度学习框架概述
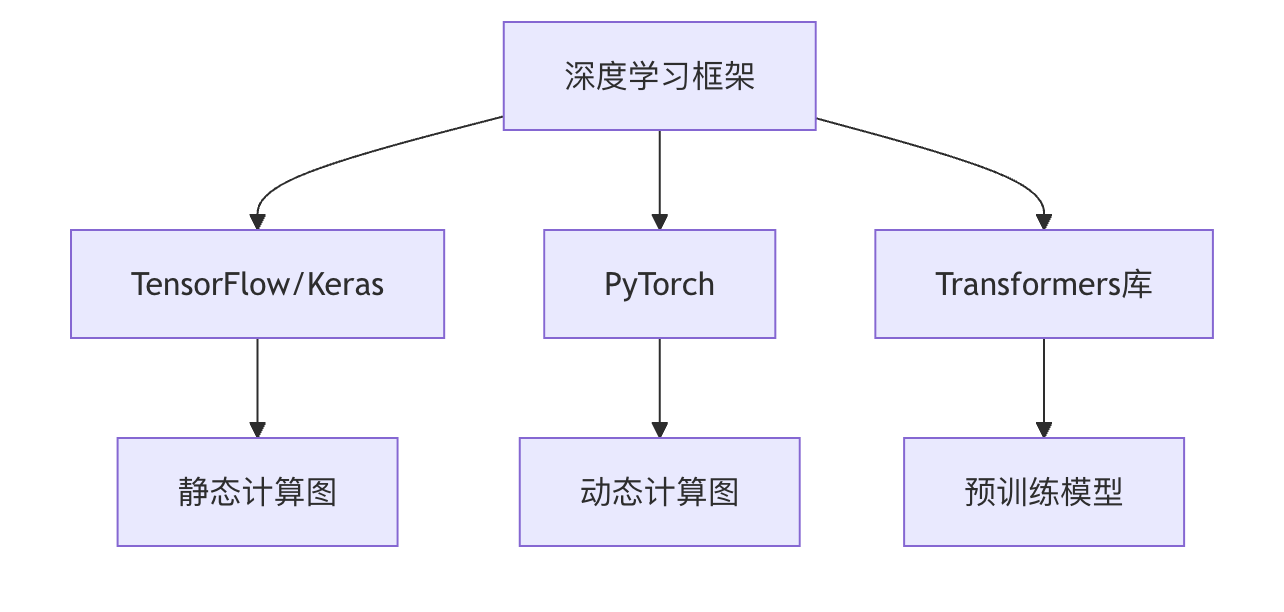
深度学习框架是现代人工智能开发的基石,它们提供了一系列工具和接口,让开发者能够高效地构建、训练和部署神经网络模型。主流的深度学习框架包括:
- TensorFlow/Keras:Google开发的工业级框架,适合生产环境
- PyTorch:Facebook主导的研究型框架,动态计算图特性突出
- Transformers 库:HuggingFace 推出的自然语言处理专用框架
TensorFlow/Keras 详解
核心架构
TensorFlow采用分层设计:
- 前端API:Python、C++等语言接口
- 计算图:将运算表示为有向无环图(DAG)
- 分布式运行时:跨CPU/GPU/TPU执行
Keras高层API
Keras作为TensorFlow的官方高阶API,简化了模型构建流程:
实例
python
from tensorflow import keras

from tensorflow.keras import layers

model = keras.Sequential([

    layers.Dense(64, activation='relu', input_shape=(784,)),

    layers.Dense(10, activation='softmax')

])

model.compile(optimizer='adam',

              loss='sparse_categorical_crossentropy',

              metrics=['accuracy'])
关键特性对比
| 特性 | TensorFlow | Keras |
|---|---|---|
| 抽象级别 | 低层 | 高层 |
| 易用性 | 较复杂 | 简单 |
| 灵活性 | 高 | 中等 |
| 典型用途 | 生产部署 | 快速原型 |
PyTorch 深度解析
动态计算图优势
PyTorch的核心特点是动态计算图(Define-by-Run),这使得:
- 调试更直观(可使用标准Python调试工具)
- 网络结构可动态变化
- 更符合Python编程习惯
典型模型构建示例
实例
python
import torch

import torch.nn as nn

import torch.optim as optim

class Net(nn.Module):

    def __init__(self):

        super(Net, self).__init__()

        self.fc1 = nn.Linear(784, 64)

        self.fc2 = nn.Linear(64, 10)


    def forward(self, x):

        x = torch.relu(self.fc1(x))

        x = torch.softmax(self.fc2(x), dim=1)

        return x

model = Net()

criterion = nn.CrossEntropyLoss()

optimizer = optim.Adam(model.parameters())
自动微分系统
PyTorch的自动微分工作原理:
- 前向传播时记录运算图
- 反向传播时自动计算梯度
- 通过
.backward()触发梯度计算
Transformers库专项讲解
预训练模型生态
HuggingFace Transformers提供了丰富的预训练模型:
- BERT (Google)
- GPT (OpenAI)
- RoBERTa (Facebook)
- T5 (Google)
典型使用流程
实例
python
from transformers import AutoTokenizer, AutoModel

# 加载预训练模型和分词器

tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")

model = AutoModel.from_pretrained("bert-base-uncased")

# 文本处理

inputs = tokenizer("Hello world!", return_tensors="pt")

outputs = model(**inputs)
模型微调模式
实例
python
from transformers import Trainer, TrainingArguments

training_args = TrainingArguments(

    output_dir='./results',

    num_train_epochs=3,

    per_device_train_batch_size=16

)

trainer = Trainer(

    model=model,

    args=training_args,

    train_dataset=train_dataset

)

trainer.train()
模型部署与优化
部署方案对比
| 方案 | 适用场景 | 工具链 |
|---|---|---|
| 本地服务 | 企业内部应用 | Flask + ONNX |
| 云端部署 | 互联网服务 | AWS SageMaker |
| 边缘计算 | IoT设备 | TensorRT |
| 移动端 | 手机应用 | Core ML |
模型优化技术
- **量化(Quantization)**:
- 将FP32转换为INT8
- 减少75%内存占用
- 加速推理速度
实例
python
import tensorflow as tf

converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)

converter.optimizations = [tf.lite.Optimize.DEFAULT]

tflite_quant_model = converter.convert()
**剪枝(Pruning)**:
- 移除不重要的神经元连接
- 典型可减少60-90%参数
- 保持模型精度基本不变
知识蒸馏:
- 大模型(teacher)指导小模型(student)
- 保留大模型的知识
- 显著减小模型体积
框架选择指南
决策因素分析
项目类型:
- 研究原型 → PyTorch
- 生产系统 → TensorFlow
- NLP任务 → Transformers
团队技能:
- Python熟练 → PyTorch
- Java/C++背景 → TensorFlow Serving
硬件环境:
- TPU → TensorFlow
- 多GPU → PyTorch Distributed
学习路线建议

实战练习
练习1:图像分类比较
分别使用TensorFlow和PyTorch实现相同的CNN模型,在CIFAR-10数据集上:
- 比较代码复杂度
- 记录训练时间
- 测试准确率差异
练习2:模型转换
将PyTorch模型转换为:
- ONNX格式
- TensorFlow Lite格式
- 比较转换前后推理速度
练习3:优化实战
选择一个预训练模型:
- 应用量化技术
- 实施剪枝
- 测量优化前后模型大小和推理速度变化
通过本教程,您应该已经掌握了主流深度学习框架的核心特性和应用场景。建议从PyTorch开始学习深度学习编程,待基础扎实后再根据项目需求扩展到其他框架。记住,框架只是工具,真正的价值在于您用它们解决的现实问题。
AI 思考中...