LangChain RAG
RAG(Retrieval-Augmented Generation,检索增强生成)让 AI 能够基于你的私有文档回答问题,不需要微调模型,只需将文档向量化存储,Agent 就能检索相关内容来回答。
RAG 是什么
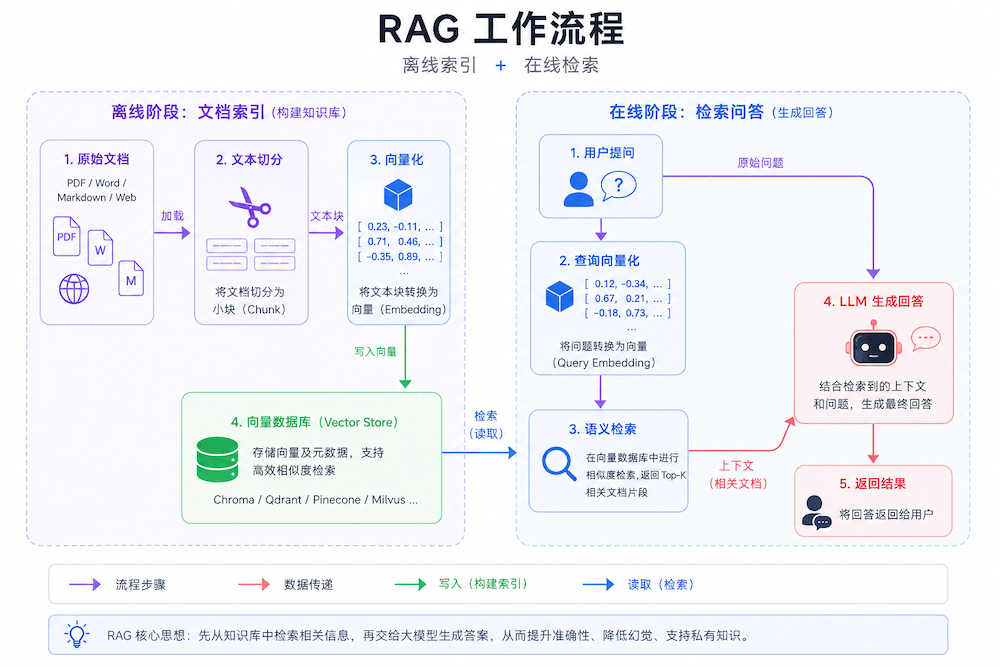
普通的大模型只能回答训练数据中有的内容。如果你的文档是私有的(公司内部文档、个人笔记),模型就"不知道"。RAG 解决了这个问题:
离线阶段:将文档切分成小块 → 用 Embedding 模型转换为向量 → 存入向量数据库在线阶段:用户提问 → 将问题转为向量 → 在向量数据库中搜索最相似的内容 → 将检索到的内容作为上下文发给模型 → 模型基于检索内容回答
RAG 工作流程
python
┌──────────────────────────────────────────────────────┐
│                    离线阶段(索引)                     │
│                                                      │
│  文档 → DocumentLoader → TextSplitter → Embedding     │
│                                           ↓          │
│                                      VectorStore     │
└──────────────────────────────────────────────────────┘

┌──────────────────────────────────────────────────────┐
│                    在线阶段(检索)                     │
│                                                      │
│  用户提问 → Embedding → 相似度搜索 → 检索结果          │
│                                          ↓           │
│                      检索结果 + 用户问题 → 模型 → 回答  │
└──────────────────────────────────────────────────────┘
环境准备
安装 RAG 相关依赖:
bash
$ pip install langchain-deepseek langchain-chroma chromadb| 包 | 用途 |
|---|---|
| langchain-deepseek | 提供 OpenAI Embedding 模型 |
| langchain-chroma | Chroma 向量数据库的 LangChain 集成 |
| chromadb | Chroma 向量数据库(轻量级,适合入门) |
Embedding 模型初始化
实例
python
from dotenv import load_dotenv

load_dotenv()

from langchain_openai import OpenAIEmbeddings

# OpenAI 的文本嵌入模型

# 将文本转换为向量(一组浮点数)

embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

# 测试:将一段文本转为向量

text = "菜鸟教程 RUNOOB 是一个编程学习平台"

vector = embeddings.embed_query(text)

print(f"文本: {text}")

print(f"向量维度: {len(vector)}")   # text-embedding-3-small 是 1536 维

print(f"向量前 5 个值: {vector[:5]}")
运行结果:
python
文本: 菜鸟教程 RUNOOB 是一个编程学习平台
向量维度: 1536
向量前 5 个值: [0.0123, -0.0045, 0.0234, -0.0012, 0.0089]
另外如果没有 OpenAI 的 key,可以使用阿里百炼的 Embedding 服务,.env 的配置文件需要加上阿里百炼的 key:
python
DASHSCOPE_API_KEY="sk-xxx"配置后的代码:
实例
python
import os

from dotenv import load_dotenv

load_dotenv()

from langchain_openai import OpenAIEmbeddings

# OpenAI 的文本嵌入模型

# 将文本转换为向量(一组浮点数)

# 使用阿里云百炼(DashScope)的通义千问 Embedding 服务

# 百炼的 Embedding 接口兼容 OpenAI 接口规范,所以直接用 langchain-openai

# 的 OpenAIEmbeddings,把 base_url 指向百炼的兼容端点即可,

# 不需要再装 langchain-community / dashscope(该包已停止维护)。

# text-embedding-v4 是目前推荐的通用向量模型,默认输出 1024 维向量。

#

# 两个关键参数不能少:

# - check_embedding_ctx_length=False:OpenAIEmbeddings 默认会用 tiktoken

#   把文本预先编码成 token id 数组再发送(OpenAI 官方接口认这个格式),

#   但百炼的兼容接口只接受原始字符串,不关掉这个选项会报

#   "contents is neither str nor list of str" 错误。

# - chunk_size=10:百炼 Embedding 接口单次请求最多接受 10 条文本,

#   OpenAIEmbeddings 默认一次打包 1000 条,知识库稍大就会超限报错。

embeddings = OpenAIEmbeddings(

    model="text-embedding-v4",

    api_key=os.getenv("DASHSCOPE_API_KEY"),

    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",

    check_embedding_ctx_length=False,

    chunk_size=10,

)

# 测试:将一段文本转为向量

text = "菜鸟教程 RUNOOB 是一个编程学习平台"

vector = embeddings.embed_query(text)

print(f"文本: {text}")

print(f"向量维度: {len(vector)}")   # text-embedding-3-small 是 1536 维

print(f"向量前 5 个值: {vector[:5]}")
创建向量存储
实例
python
from langchain_openai import OpenAIEmbeddings

from langchain_chroma import Chroma

# 初始化 Embedding 模型

embeddings = OpenAIEmbeddings(model="text-embedding-3-small")

# 创建 Chroma 向量存储(数据保存在本地目录)

vector_store = Chroma(

    collection_name="runoob_docs",

    embedding_function=embeddings,

    persist_directory="./chroma_db",  # 持久化目录

)

# 添加文档(最简单的形式:文本列表)

texts = [

    "菜鸟教程(RUNOOB)是一个免费的编程学习网站,提供 HTML、CSS、JavaScript、Python 等教程。",

    "Python3 基础教程共 30 章,适合零基础入门,包含环境搭建、语法基础、面向对象等内容。",

    "HTML 基础教程共 25 章,覆盖 HTML 标签、表单、多媒体等基础知识。",

]

# add_texts 自动将文本转为向量并存储

vector_store.add_texts(texts)

print(f"已添加 {len(texts)} 个文档到向量存储")
语义检索
实例
python
# 语义搜索——不依赖关键词匹配,而是语义相似度

results = vector_store.similarity_search(

    "我想学 Python,有什么教程推荐?",

    k=2,  # 返回最相似的 2 个结果

)

print("搜索结果:")

for i, doc in enumerate(results):

    print(f"\n结果 {i+1}:")

    print(f"  内容: {doc.page_content}")

    print(f"  元数据: {doc.metadata}")
运行结果:
python
搜索结果:

结果 1:
  内容: Python3 基础教程共 30 章,适合零基础入门...
  元数据: {}

结果 2:
  内容: 菜鸟教程(RUNOOB)是一个免费的编程学习网站...
  元数据: {}
注意第一个搜索结果比第二个更相关——虽然第一个包含 "Python" 关键词,但它按
语义相似度而非关键词匹配排序。这就是向量检索的优势。
创建 Retriever 检索器
Retriever 是 Vector Store 的标准化接口:
实例
python
# 从 vector_store 创建 retriever

retriever = vector_store.as_retriever(

    search_type="similarity",  # 相似度搜索

    search_kwargs={"k": 3},    # 返回前 3 个结果

)

# 使用 retriever

docs = retriever.invoke("Python 学习路线")

for doc in docs:

    print(f"- {doc.page_content[:60]}...")
AI 思考中...