LangChain 中间件(Middleware)
LangChain Middleware(中间件)是 LangChain 最强大的特性。它让你在 Agent 执行的各个环节插入自定义逻辑,实现重试、降级、缓存、内容过滤、日志记录等功能——而不需要修改 Agent 本身的代码。
什么是 Middleware
Middleware 是 Agent 执行流程中的钩子(Hook)。每个钩子让你在特定的时间点执行自定义代码:
实例
python
# Middleware 的直观理解:

# 假设 Agent 的执行流程是这样的:

# 1. 用户输入 → 2. 模型思考 → 3. 可能调用工具 → 4. 模型再思考 → 5. 输出结果

# Middleware 让你可以在这 5 个环节之间插入自定义逻辑:

# 1. 用户输入

#    ↓ [before_agent 钩子:日志记录、权限检查]

# 2. 模型思考

#    ↓ [before_model 钩子:消息预处理]

#    ↓ [wrap_model_call 钩子:重试、降级、缓存]

#    ↓ [after_model 钩子:内容审核]

# 3. 工具执行

#    ↓ [wrap_tool_call 钩子:工具调用重试]

# 4. 回到模型思考(循环直到完成)

#    ↓ [after_agent 钩子:结果格式化、统计分析]

# 5. 输出结果
六个钩子点
LangChain 的 Middleware 提供了 6 个钩子,按执行时机分为两类:
| 钩子 | 执行频率 | 执行位置 | 主要用途 |
|---|---|---|---|
| before_agent | 一次 | Agent 开始前 | 初始化、权限检查、输入预处理 |
| before_model | 每次循环 | 模型调用前 | 消息预处理、动态上下文注入 |
| wrap_model_call | 每次循环 | 包裹模型调用 | 重试、降级、缓存、请求改写 |
| after_model | 每次循环 | 模型调用后 | 内容审核、响应过滤、日志 |
| wrap_tool_call | 每次工具调用 | 包裹工具执行 | 工具重试、结果缓存、参数改写 |
| after_agent | 一次 | Agent 结束后 | 格式化输出、统计、清理资源 |
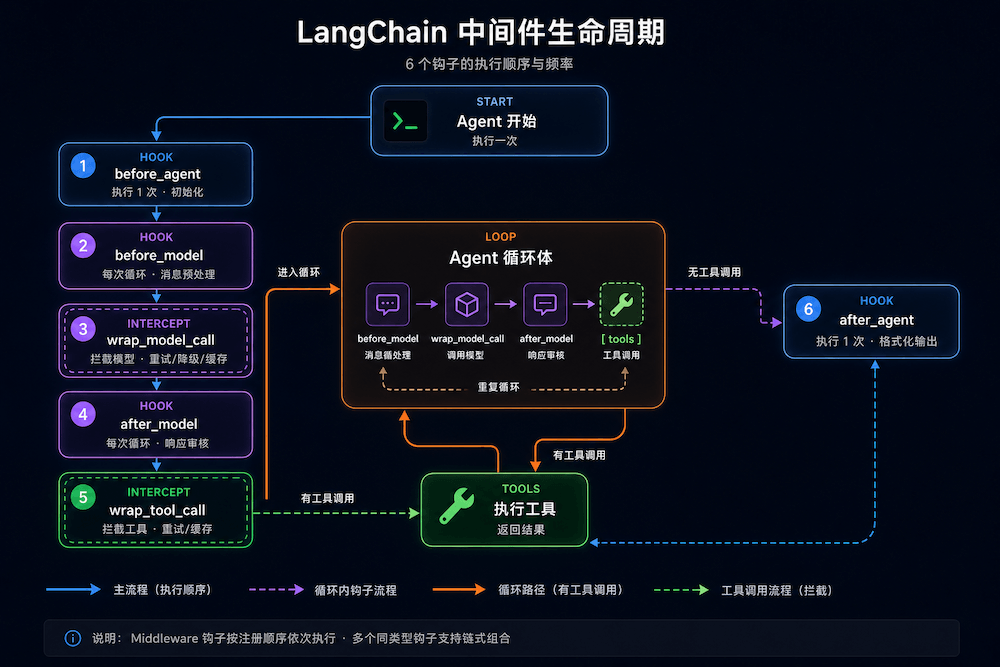
两种使用方式
Middleware 可以通过类继承或装饰器两种方式使用:
方式 1:装饰器(推荐)
实例
python
from langchain.agents.middleware import before_model, after_model

# 装饰器方式:简单、直观

@before_model

def log_before(state, runtime):

    """在每次模型调用前记录日志"""

    msg_count = len(state.get("messages", []))

    print(f"[before_model] 当前消息数: {msg_count}")

    return None

@after_model

def log_after(state, runtime):

    """在每次模型调用后记录日志"""

    last_msg = state["messages"][-1] if state.get("messages") else None

    if last_msg and hasattr(last_msg, 'tool_calls') and last_msg.tool_calls:

        print(f"[after_model] 模型请求了工具调用")

    return None
方式 2:类继承(适合复杂逻辑)
实例
python
from langchain.agents.middleware import AgentMiddleware

class LoggingMiddleware(AgentMiddleware):

    """自定义日志中间件"""

    @property

    def name(self) -> str:

        # 自定义中间件名称(默认是类名)

        return "logging"

    def before_agent(self, state, runtime):

        """Agent 开始前的逻辑"""

        print("[Logging] Agent 开始执行")

        return None

    def before_model(self, state, runtime):

        """模型调用前的逻辑"""

        msg_count = len(state.get("messages", []))

        print(f"[Logging] 准备调用模型,当前 {msg_count} 条消息")

        return None

    def after_model(self, state, runtime):

        """模型调用后的逻辑"""

        print("[Logging] 模型调用完成")

        return None

    def after_agent(self, state, runtime):

        """Agent 结束后的逻辑"""

        print("[Logging] Agent 执行结束")

        return None
完整的生命周期示例
实例
python
from dotenv import load_dotenv

load_dotenv()

from langchain.agents import create_agent

from langchain.agents.middleware import (

    before_agent, after_agent,

    before_model, after_model,

)

from langchain.chat_models import init_chat_model

from langchain.messages import HumanMessage

from langchain.tools import tool

@before_agent

def start_log(state, runtime):

    """Agent 开始前"""

    print(">>> [before_agent] Agent 开始 <<<")

    runtime.stream_writer({"type": "lifecycle", "phase": "start"})

    return None

@before_model

def pre_model(state, runtime):

    """每次模型调用前"""

    msg_count = len(state.get("messages", []))

    print(f"  -> [before_model] 第 {msg_count} 条消息")

    return None

@after_model

def post_model(state, runtime):

    """每次模型调用后"""

    last = state["messages"][-1] if state.get("messages") else None

    if hasattr(last, 'tool_calls') and last.tool_calls:

        tools = [tc['name'] for tc in last.tool_calls]

        print(f"  <- [after_model] 请求工具: {tools}")

    else:

        content = str(last.content)[:50] if last and hasattr(last, 'content') else ""

        print(f"  <- [after_model] 直接回复: {content}...")

    return None

@after_agent

def end_log(state, runtime):

    """Agent 结束后"""

    total_msgs = len(state.get("messages", []))

    print(f"<<< [after_agent] Agent 结束,共 {total_msgs} 条消息 <<<")

    return None

@tool

def get_weather(city: str) -> str:

    """查询天气"""

    return f"{city}: 晴,25°C"

model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)

agent = create_agent(

    model=model,

    tools=[get_weather],

    middleware=[start_log, pre_model, post_model, end_log],

    system_prompt="你是助手。",

)

print("\n========== 第一个问题(需要工具) ==========")

result = agent.invoke({

    "messages": [HumanMessage(content="杭州天气?")]

})

print(f"\n最终回复: {result['messages'][-1].content}")

print("\n========== 第二个问题(无需工具) ==========")

result = agent.invoke({

    "messages": [HumanMessage(content="你好")]

})

print(f"\n最终回复: {result['messages'][-1].content}")
运行结果:
python
========== 第一个问题(需要工具) ==========
>>> [before_agent] Agent 开始 <<<
  -> [before_model] 第 2 条消息
  <- [after_model] 请求工具: ['get_weather']
  -> [before_model] 第 3 条消息
  <- [after_model] 直接回复: 杭州今天晴,气温25°C。...
<<< [after_agent] Agent 结束,共 4 条消息 <<<

最终回复: 杭州今天晴,气温25°C。

========== 第二个问题(无需工具) ==========
>>> [before_agent] Agent 开始 <<<
  -> [before_model] 第 1 条消息
  <- [after_model] 直接回复: 你好!有什么可以帮你的?...
<<< [after_agent] Agent 结束,共 2 条消息 <<<

最终回复: 你好!有什么可以帮你的?
从输出可以看到:
before\_agent 和 after\_agent:每个问题只执行一次before\_model 和 after\_model:每次模型调用都执行(第一个问题调用了两次模型,所以各执行两次)
Middleware 的返回值
Middleware 的返回值决定了是否要修改 Agent 状态或控制流程:
| 返回值 | 效果 | 示例 |
|---|---|---|
| None | 不修改任何状态,继续正常流程 | 纯日志记录 |
| dict | 更新 Agent 状态(合并到当前状态) | 返回 {"custom_field": "value"} |
| 含 jump_to 的 dict | 跳转到指定节点 | 返回 {"jump_to": "end"} |
返回的 dict 会通过 Agent 状态的 reducer 合并。对于 messages 字段,使用 add_messages reducer,所以返回的 messages 会追加而非覆盖。
AI 思考中...