PyTorch 实例 - 文本情感分析项目
文本情感分析是自然语言处理(NLP)中的一项基础任务,旨在判断一段文本表达的情感倾向(正面/负面)。本项目将使用PyTorch构建一个深度学习模型,实现对电影评论的情感分类。
情感分析的应用场景
- 产品评论分析
- 社交媒体舆情监控
- 客户服务反馈分类
- 市场趋势预测
环境准备
所需工具和库
实例
python
import torch

import torch.nn as nn

import torch.optim as optim

from torchtext.data import Field, TabularDataset, BucketIterator

import spacy

import numpy as np
安装依赖
bash
pip install torch torchtext spacy
python -m spacy download en_core_web_sm
数据准备
数据集介绍
使用IMDB电影评论数据集,包含50,000条带有情感标签(正面/负面)的评论。
数据预处理
实例
python
# 定义字段处理

TEXT = Field(tokenize='spacy',

            tokenizer_language='en_core_web_sm',

            include_lengths=True)

LABEL = Field(sequential=False, use_vocab=False)

# 加载数据集

train_data, test_data = TabularDataset.splits(

    path='./data',

    train='train.csv',

    test='test.csv',

    format='csv',

    fields=[('text', TEXT), ('label', LABEL)]

)

# 构建词汇表

TEXT.build_vocab(train_data,

                max_size=25000,

                vectors="glove.6B.100d")
模型构建
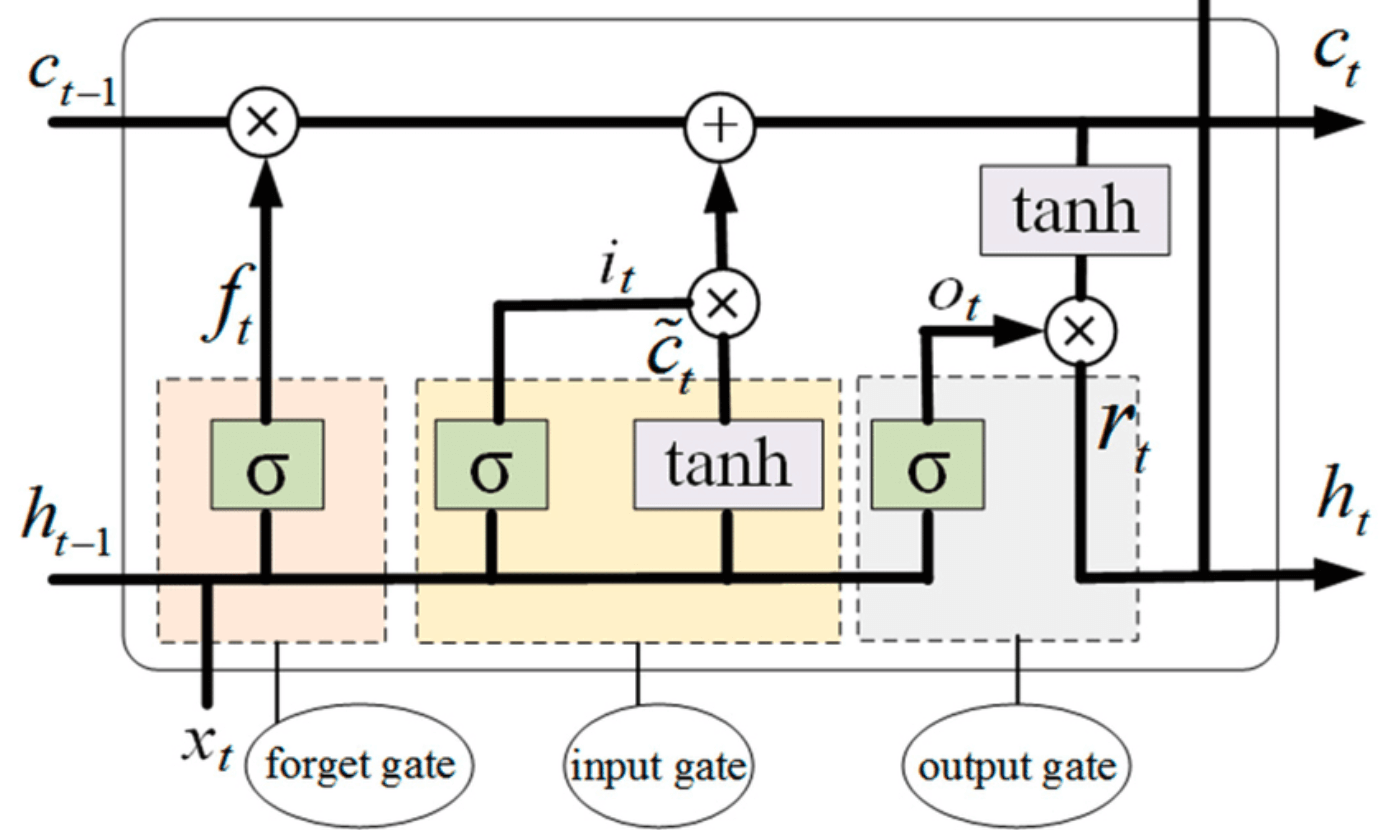
LSTM模型架构
4.2 模型实现代码
实例
python
class SentimentLSTM(nn.Module):

    def __init__(self, vocab_size, embedding_dim, hidden_dim, output_dim, n_layers):

        super().__init__()

        self.embedding = nn.Embedding(vocab_size, embedding_dim)

        self.lstm = nn.LSTM(embedding_dim,

                           hidden_dim,

                           num_layers=n_layers,

                           bidirectional=True)

        self.fc = nn.Linear(hidden_dim * 2, output_dim)

        self.dropout = nn.Dropout(0.5)


    def forward(self, text, text_lengths):

        embedded = self.dropout(self.embedding(text))

        packed_embedded = nn.utils.rnn.pack_padded_sequence(

            embedded, text_lengths.to('cpu'))

        packed_output, (hidden, cell) = self.lstm(packed_embedded)

        hidden = self.dropout(torch.cat((hidden[-2,:,:], hidden[-1,:,:]), dim=1))

        return self.fc(hidden)
模型训练
训练参数设置
实例
python
# 模型参数

INPUT_DIM = len(TEXT.vocab)

EMBEDDING_DIM = 100

HIDDEN_DIM = 256

OUTPUT_DIM = 1

N_LAYERS = 2

# 初始化模型

model = SentimentLSTM(INPUT_DIM, EMBEDDING_DIM, HIDDEN_DIM, OUTPUT_DIM, N_LAYERS)

# 优化器和损失函数

optimizer = optim.Adam(model.parameters())

criterion = nn.BCEWithLogitsLoss()
训练循环
实例
python
def train(model, iterator, optimizer, criterion):

    epoch_loss = 0

    epoch_acc = 0


    model.train()


    for batch in iterator:

        text, text_lengths = batch.text

        predictions = model(text, text_lengths).squeeze(1)

        loss = criterion(predictions, batch.label)


        optimizer.zero_grad()

        loss.backward()

        optimizer.step()


        epoch_loss += loss.item()

        epoch_acc += accuracy(predictions, batch.label)


    return epoch_loss / len(iterator), epoch_acc / len(iterator)
模型评估
评估函数
实例
python
def evaluate(model, iterator, criterion):

    epoch_loss = 0

    epoch_acc = 0


    model.eval()


    with torch.no_grad():

        for batch in iterator:

            text, text_lengths = batch.text

            predictions = model(text, text_lengths).squeeze(1)

            loss = criterion(predictions, batch.label)

            epoch_loss += loss.item()

            epoch_acc += accuracy(predictions, batch.label)


    return epoch_loss / len(iterator), epoch_acc / len(iterator)
准确率计算
实例
python
def accuracy(preds, y):

    rounded_preds = torch.round(torch.sigmoid(preds))

    correct = (rounded_preds == y).float()

    acc = correct.sum() / len(correct)

    return acc
模型应用
预测新文本
实例
python
def predict_sentiment(model, sentence):

    tokenized = [tok.text for tok in nlp.tokenizer(sentence)]

    indexed = [TEXT.vocab.stoi[t] for t in tokenized]

    length = [len(indexed)]

    tensor = torch.LongTensor(indexed).to(device)

    tensor = tensor.unsqueeze(1)

    length_tensor = torch.LongTensor(length)

    prediction = torch.sigmoid(model(tensor, length_tensor))

    return prediction.item()
示例预测
实例
python
positive_review = "This movie was fantastic! I really enjoyed it."

negative_review = "The film was terrible and boring."

print(f"Positive review score: {predict_sentiment(model, positive_review):.4f}")

print(f"Negative review score: {predict_sentiment(model, negative_review):.4f}")
AI 思考中...